슈퍼플래닛
여러 게임이 같이 쓰는 공통 플랫폼(인증·결제·리워드·지표) 서버와 사내 운영툴을 개발하고 AWS 인프라와 장애 대응을 맡고 있습니다. 콘솔에서 23단계를 손으로 하던 EC2 배포를 EKS GitOps로 옮기고, 모듈마다 복사돼 갈라진 서버 프레임워크를 공용 모듈 하나로 다시 만들고 있습니다. 서버 팀은 3명이고 이 전환은 혼자 맡아 진행하고 있습니다.
- 상태
- 재직 중
- 역할
- 백엔드 · 인프라 · 산업기능요원 (보충역 · 전직 가능)
- 기술
- Kubernetes (AWS EKS Auto Mode), Argo CD · Argo Rollouts, AWS (CodePipeline · CodeBuild · ECR · ALB · Aurora · S3 · Secrets Manager), Java 17 · 21 · 25 · Jakarta Servlet · Tomcat, Maven · MyBatis · HikariCP · gRPC, MySQL · Aurora · Redis · SQS, Terraform · Helm · Bash · Python, Prometheus · Grafana · Fluent Bit · Headscale
- 배포 시간 (테스트 포함, 약)
- 5분
- dev 자동 배포
- 180회
- framework로 옮긴 뒤 응답 차이 (core 10,847건)
- 0건
- core 부하 시험 처리량 (동시 300)
- 210 → 1,208 req/s
- 누락 결제 재처리
- 5일치
- 서버 팀 (전환은 단독)
- 3명
담당 작업
- 결제·보상·지표·로깅·광고 지표 API를 개발하고 유지보수합니다.
- EC2 배포를 EKS·Argo CD 기반 GitOps로 옮기고 있습니다. AWS 계정 2개의 Terraform과 빌드 파이프라인, 경보와 대시보드까지 혼자 맡습니다.
- 레거시 코드를 모듈별로 읽으며 반복되는 문제를 21가지 유형으로 정리했고, 공용 framework로 하나씩 고치고 있습니다.
- 사내 운영툴의 로그인(OIDC)과 도구·게임별 권한 관리 서버를 새로 만들고 있습니다.
- 웹게임 서버를 구현하고 CS 기술 지원과 트러블슈팅을 맡습니다.
문제 해결 사례
제목을 누르면 접근과 결과가 펼쳐집니다.
로그에 흔적이 없던 iOS 결제 누락, 5일치 전부 재처리
iOS 결제가 줄었는데 서버 로그와 관련 테이블 세 곳 어디에도 실패 흔적이 없었습니다. 영향을 받은 기간은 5일이었습니다.
iOS 결제가 줄었는데 서버 로그와 관련 테이블 세 곳 어디에도 실패 흔적이 없었습니다. 영향을 받은 기간은 5일이었습니다.
접근
DB 기록과 코드 경로를 단계별로 확인한 뒤 영수증을 직접 디코딩했습니다. 클라이언트가 StoreKit 2로 바뀐 뒤 레거시 영수증에서 in_app 필드가 빠졌습니다. 검증 코드는 이때 생기는 예외를 삼키고 있었습니다.
결과
검증 로직을 고친 뒤 영향을 받은 5일치 결제를 전부 다시 처리했습니다. 대상은 전에 실패한 요청을 따로 DB에 쌓도록 모듈들을 고쳐 둔 기록에서 찾았습니다.
콘솔 수작업 23단계 배포를 GitOps로, 테스트 포함 약 5분
배포할 때마다 AWS 콘솔에서 베이스 서버로 AMI를 만들고, 런치 템플릿 새 버전을 올리고, Auto Scaling 인스턴스를 교체한 뒤 상태를 눈으로 확인했습니다. 매뉴얼 기준 23단계였고 WAR는 로컬에서 빌드했습니다. 서버마다 Java와 Tomcat 버전이 달랐고, 문제가 생기면 런치 템플릿을 이전 AMI로 되돌려야 해서 복구에 시간이 걸렸습니다.
배포할 때마다 AWS 콘솔에서 베이스 서버로 AMI를 만들고, 런치 템플릿 새 버전을 올리고, Auto Scaling 인스턴스를 교체한 뒤 상태를 눈으로 확인했습니다. 매뉴얼 기준 23단계였고 WAR는 로컬에서 빌드했습니다. 서버마다 Java와 Tomcat 버전이 달랐고, 문제가 생기면 런치 템플릿을 이전 AMI로 되돌려야 해서 복구에 시간이 걸렸습니다.
접근
AWS 계정 2개와 EKS(Auto Mode) 클러스터 2개를 Terraform으로 만들었습니다. 서비스마다 CodePipeline이 이미지를 빌드하고 기동 검사를 거쳐 ECR에 올린 뒤 GitOps 레포에 digest를 커밋하면 Argo CD가 반영합니다. 새 버전은 50%까지 나간 상태에서 4분 동안 재시작과 5xx를 보고 이상하면 함께 떠 있는 이전 버전으로 돌아갑니다. 서버 팀 3명 중 전환 작업은 혼자 맡고 있습니다.
결과
배포는 테스트를 포함해 약 5분이고 테스트가 실패하면 바로 멈춥니다. 사내 모듈 7개와 게임 서버 1개가 dev 클러스터에서 돌고, dev 자동 배포는 180회였습니다. 운영 트래픽은 아직 EC2가 받습니다. 전환은 DNS 교체로 하고 명령 한 번으로 되돌리도록 준비해 두었습니다.
재시작을 반복하는 배포가 '배포 성공'으로 기록
파드가 CrashLoopBackOff에 빠진 배포가 Slack에는 'dev 배포 성공'으로, 배포 기록에도 성공으로 남았습니다. 이 기록은 운영 반영의 근거로 쓰입니다. 기록하기 전에 새 버전이 실제로 응답하는지는 보지 않고 있었습니다.
파드가 CrashLoopBackOff에 빠진 배포가 Slack에는 'dev 배포 성공'으로, 배포 기록에도 성공으로 남았습니다. 이 기록은 운영 반영의 근거로 쓰입니다. 기록하기 전에 새 버전이 실제로 응답하는지는 보지 않고 있었습니다.
접근
기록 전에 dev 주소의 상태 응답을 확인하는 Record 단계를 넣었습니다. 연속 10번 2xx이고 응답의 buildSha가 이번 배포 ID와 같아야 기록하고, 15분 안에 통과하지 못하면 파이프라인을 실패시킵니다. 카나리 자동 중단은 재시작과 5xx, 시간 초과를 봅니다. 5xx 판정이 가장 늦게 걸리는 경우를 계산하니 약 195초여서 카나리 대기를 3분에서 4분으로 늘렸습니다.
결과
5xx가 2분에 5건 미만(분당 2.5건 미만)이면 판정에 걸리지 않을 수 있습니다. 이 한계는 런북에 적어 두었습니다.
애드온 버전을 비워 둔 탓에 Argo CD 앱 15개가 Unknown
Argo CD 앱 15개가 모두 Unknown이 됐고 배포와 설정 변경이 반영되지 않았습니다. 돌고 있던 서비스에는 영향이 없었습니다. kubectl은 정상이고 APIService도 Available이라 처음에는 Argo CD 쪽 문제로 보였습니다.
Argo CD 앱 15개가 모두 Unknown이 됐고 배포와 설정 변경이 반영되지 않았습니다. 돌고 있던 서비스에는 영향이 없었습니다. kubectl은 정상이고 APIService도 Available이라 처음에는 Argo CD 쪽 문제로 보였습니다.
접근
같은 /openapi/v2 요청을 응답 형식만 바꿔 보내 보니 Argo CD가 받는 protobuf 형식에서만 실패했습니다. CloudTrail을 따라가니 그날 Terraform apply가 metrics-server 애드온을 AWS 기본 버전으로 바꿔 놓았습니다. 버전 변수가 비어 있었고, plan에 나온 변경은 승인 때 다른 변경에 묻혀 지나갔습니다. 애드온을 이전 버전으로 되돌려 해소했습니다.
결과
애드온 버전은 모두 고정했고 값이 비었거나 형식이 틀리면 plan이 실패합니다. 스키마를 1분마다 protobuf로 받아 보고 5분 내리 실패하면 울리는 경보를 추가했습니다. 클러스터 객체를 누가 바꿨는지 시간순으로 뽑는 감사 로그 쿼리도 저장해 두었습니다. 이 사고부터 사고 기록을 문서로 남기기 시작했습니다.
같은 프레임워크 사본 14벌을 응답 차이 0건으로 하나로
서버 모듈 14개가 같은 프레임워크를 각자 복사해 쓰고 있었습니다(모듈당 27~36파일). 사본끼리 갈라져 요청 진입 클래스는 6벌, 액션 처리 클래스는 9벌이었고 같은 수정이 모듈마다 다르게 들어가 있었습니다. 빌드 도구 없이 IDE 설정으로 WAR를 만들고 jar 291개를 레포에 커밋해 두어서 컨테이너 빌드를 붙이기도 어려웠습니다.
서버 모듈 14개가 같은 프레임워크를 각자 복사해 쓰고 있었습니다(모듈당 27~36파일). 사본끼리 갈라져 요청 진입 클래스는 6벌, 액션 처리 클래스는 9벌이었고 같은 수정이 모듈마다 다르게 들어가 있었습니다. 빌드 도구 없이 IDE 설정으로 WAR를 만들고 jar 291개를 레포에 커밋해 두어서 컨테이너 빌드를 붙이기도 어려웠습니다.
접근
공용 framework 하나와 Maven 멀티모듈로 바꾸고 Java 17·Tomcat 9에서 Java 25·Tomcat 11로 한 번에 올렸습니다. 둘 다 지원이 끝났거나 끝나 가는 버전이었고, 어차피 올려야 한다면 지원 기간이 가장 긴 최신 버전으로 가야 다음 업그레이드를 미룰 수 있습니다. 같은 소스면 같은 WAR가 나오도록 빌드 시각을 고정했습니다. 모듈을 하나씩 옮기면서 옛 빌드와 새 빌드를 dev 읽기 전용 DB에 함께 붙이고 같은 요청을 보내 응답을 비교했습니다. JSON 키 순서는 옛 서버도 재시작할 때마다 바뀌어서 순서는 맞춘 뒤 비교했습니다.
결과
core 요청 10,847건(결제 753건 포함), support 505건, market 238건에서 응답 차이는 0건이었습니다. 6개 모듈을 옮겼고 복제본 182파일(약 1.25만 줄)을 지웠습니다. 옮긴 모듈은 dev 클러스터에서 돌고 운영은 아직 EC2입니다.
부하 시험에서 드러난 커넥션 풀 교착, 210 → 1,208 req/s
core 모듈에 동시 300 부하를 넣자 처리량이 210 req/s, p95가 10초였습니다. 결제 실패 로그를 남기는 코드가 요청이 쓰던 연결을 쥔 채 두 번째 연결을 기다렸고, 그런 스레드 15개가 풀 전체를 막았습니다. 옛 MyBatis 풀은 10초 넘은 연결을 강제로 회수했기 때문에 이 문제가 드러나지 않았습니다.
core 모듈에 동시 300 부하를 넣자 처리량이 210 req/s, p95가 10초였습니다. 결제 실패 로그를 남기는 코드가 요청이 쓰던 연결을 쥔 채 두 번째 연결을 기다렸고, 그런 스레드 15개가 풀 전체를 막았습니다. 옛 MyBatis 풀은 10초 넘은 연결을 강제로 회수했기 때문에 이 문제가 드러나지 않았습니다.
접근
따로 커밋하는 로그는 DB마다 둔 보조 풀을 쓰게 하고 커넥션 누수 감지를 붙였습니다.
결과
같은 시험에서 1,208 req/s, p95 0.5초, 연결 타임아웃 0건이 나왔습니다.
서버를 한 대씩 호출하던 설정 반영을 변경 감지로
운영툴에서 설정 테이블을 바꾸면 운영툴이 서버 목록을 받아 한 대씩 reload를 호출했습니다. EKS에서는 파드 주소가 계속 바뀌어 이 방식을 쓸 수 없습니다. 일부 모듈처럼 서버마다 15초마다 체크섬을 확인하면 파드 수만큼 DB 조회가 늘고, 기동 때 한 번만 읽는 모듈은 새 게임이 재시작 전까지 보이지 않았습니다.
운영툴에서 설정 테이블을 바꾸면 운영툴이 서버 목록을 받아 한 대씩 reload를 호출했습니다. EKS에서는 파드 주소가 계속 바뀌어 이 방식을 쓸 수 없습니다. 일부 모듈처럼 서버마다 15초마다 체크섬을 확인하면 파드 수만큼 DB 조회가 늘고, 기동 때 한 번만 읽는 모듈은 새 게임이 재시작 전까지 보이지 않았습니다.
접근
1단계로 공용 컴포넌트를 만들어 바뀐 세트만 다시 읽게 했습니다. 새 데이터를 다 만든 뒤 한 번에 바꾸고, 읽다가 실패하면 이전 값을 유지합니다. 기동 때 꼭 필요한 세트를 못 읽으면 readiness를 올리지 않습니다. 다시 읽은 파드는 Redis pub/sub로 다른 파드에 알립니다.
2단계는 DB 트리거가 버전 테이블을 올리고, 모듈마다 Redis lease로 정한 감시자 하나가 1초마다 버전을 확인해 알리는 방식입니다. 감시자는 30초마다 하트비트를 보내고 90초 동안 없으면 파드들이 폴링으로 돌아갑니다.
결과
1단계는 dev에 반영돼 있습니다. 2단계는 작업 브랜치에 구현해 두었고 트리거 DDL은 아직 운영 DB에 적용하지 않았습니다.
Keycloak 대신 OIDC 서버를 직접, 리허설에서 나온 응답 차이 756건
운영툴 로그인과 권한을 한 서버로 모으려면, 이미 옛 권한 API(v1)에 맞춰 돌아가는 도구들이 그대로 동작해야 했습니다.
운영툴 로그인과 권한을 한 서버로 모으려면, 이미 옛 권한 API(v1)에 맞춰 돌아가는 도구들이 그대로 동작해야 했습니다.
접근
Grafana·사내 VPN 같은 외부 도구를 OAuth로 붙일 OIDC 제공자가 필요했고, Cognito로 가면 AWS 의존이 더 늘어나서 직접 만들었습니다. 사내 OIDC 서버(Authorization Code + PKCE, ES256 JWT)를 만들고 권한은 팀 도구 × 담당 게임에 개인 예외를 더한 원장 하나로 계산하게 했습니다. v1은 응답을 그대로 유지하는 호환층으로 남기고 Deprecation 헤더와 도구별 마지막 사용 시각을 기록합니다. 운영 DB 사본에 이관을 리허설하고 v1 응답을 옛 서버와 비교했습니다.
결과
게임 구분이 없는 도구에 다른 게임 코드로 요청하면 옛 서버는 422를 주는데 새 서버는 200을 주는 경우가 756건 나왔고, 옛 동작에 맞춰 고쳤습니다. dev에서는 Grafana와 사내 VPN이 이 서버로 로그인합니다.
재화 차감과 외부 쿠폰 발급의 정합성, Hold → Capture → Release 원장
플랫폼 재화를 차감하는 서버와 외부 쿠폰을 발급하는 서버가 달라서 한쪽만 성공하면 재화와 쿠폰이 어긋날 수 있었습니다. 장애 복구 뒤 시퀀스가 재사용되면 다른 사용자에게 쿠폰이 나갈 위험도 있었습니다.
플랫폼 재화를 차감하는 서버와 외부 쿠폰을 발급하는 서버가 달라서 한쪽만 성공하면 재화와 쿠폰이 어긋날 수 있었습니다. 장애 복구 뒤 시퀀스가 재사용되면 다른 사용자에게 쿠폰이 나갈 위험도 있었습니다.
접근
잠금(Hold) → 확정(Capture) → 해제(Release) 3단계 원장과 7단계 주문 상태로 나누고 단계마다 롤백 방법을 정했습니다. 잠금 단계에서는 잔액만 묶고 원장에는 쓰지 않습니다. 발급이 성공하면 확정하고 실패하면 잠금을 풉니다. 재시도 식별자는 CSPRNG 멱등키로 바꿨습니다.
결과
운영에 반영돼 있습니다.
계정 연동 뒤 사라진 결제 내역, 원인은 INNER JOIN
운영툴에서 일부 사용자의 영수증이 조회되지 않았습니다. 계정을 연동하면 결제 테이블에 옛 식별자가 남아 INNER JOIN에서 행이 빠지고 있었습니다.
운영툴에서 일부 사용자의 영수증이 조회되지 않았습니다. 계정을 연동하면 결제 테이블에 옛 식별자가 남아 INNER JOIN에서 행이 빠지고 있었습니다.
접근
Read Replica에서 실행계획을 확인했습니다. 옛 식별자와 새 식별자를 OR 조건으로 조인하면 풀스캔이 나서 LEFT JOIN과 불변 식별자 매핑으로 바꾸고 15초 타임아웃을 걸었습니다.
서버 다운을 몇 시간 뒤에 알던 상태에서 분 단위 알림까지
중앙 로그와 알림이 없어서 서버가 내려가도 몇 시간 뒤에야 아는 일이 있었습니다. 디스크가 차면 SSH로 들어가 로그를 지웠습니다.
중앙 로그와 알림이 없어서 서버가 내려가도 몇 시간 뒤에야 아는 일이 있었습니다. 디스크가 차면 SSH로 들어가 로그를 지웠습니다.
접근
Prometheus·Alertmanager·Grafana를 올리고 경보마다 원인 분류와 가린 로그, 런북 링크를 붙여 보내는 Slack 봇을 만들었습니다. 감시 체계가 통째로 죽는 경우는 클러스터 밖 데드맨 알람이 잡습니다. 관리 화면은 사내 VPN으로만 열립니다.
결과
지금은 분 단위로 상태를 확인합니다. 기동이 정상이어도 5xx가 늘면 바로 알림이 옵니다.
다른 모듈의 DB 4개를 직접 읽던 조회 경로 분리
한 모듈이 다른 모듈의 DB 4개에 직접 붙어 대량 조회를 하고 있었습니다.
한 모듈이 다른 모듈의 DB 4개에 직접 붙어 대량 조회를 하고 있었습니다.
접근
대량 조회는 Read Replica 경로로 돌렸습니다. 메인 DB가 느려져도 사용자 행동 로그가 사라지지 않도록 로깅 앞에 비동기 큐를 두었습니다.
배포 환경 (EKS · Argo CD)
전환 전 배포 절차
운영 서버는 게임마다 Auto Scaling 그룹으로 돌고 배포는 AWS 콘솔에서 손으로 했습니다. WAR를 로컬에서 빌드해 서비스마다 24시간 켜 둔 베이스 EC2에 올리고, 그 서버로 AMI를 떠서 Auto Scaling 그룹 전체를 교체하는 방식입니다. 패치 매뉴얼의 순서는 아래 표와 같고 번호가 붙은 단계만 23개입니다.
서버마다 Java·Tomcat·javax/jakarta 버전이 달랐고 dev에는 로드밸런서가 없었습니다. 서버를 내릴 때는 shutdown.sh 뒤 3초를 기다리는 것이 전부라 처리 중인 요청을 기다리지 않았습니다. 배포 전에 늘 도는 자동 회귀 테스트도 없었습니다.
| 순서 | 콘솔에서 한 일 | 단계 |
|---|---|---|
| AMI 만들기 | 게임 코드로 베이스 서버를 찾아 이미지를 만들고, 게임별 기존 AMI를 보며 설정값 입력 | 3 |
| 런치 템플릿 | 새 버전 만들기 → 원본 버전 확인 → AMI 선택 → 인스턴스 타입·gp3·user data 확인 → 기본 버전 지정 | 10 |
| 서버 교체 | Auto Scaling 인스턴스 새로 고침. 새 서버를 먼저 띄우고 정상 비율 100~150%, Skip matching 해제 확인 | 6 |
| 확인 | Auto Scaling 그룹과 대상 그룹에서 Healthy인지 눈으로 확인 | 4 |
계정과 클러스터
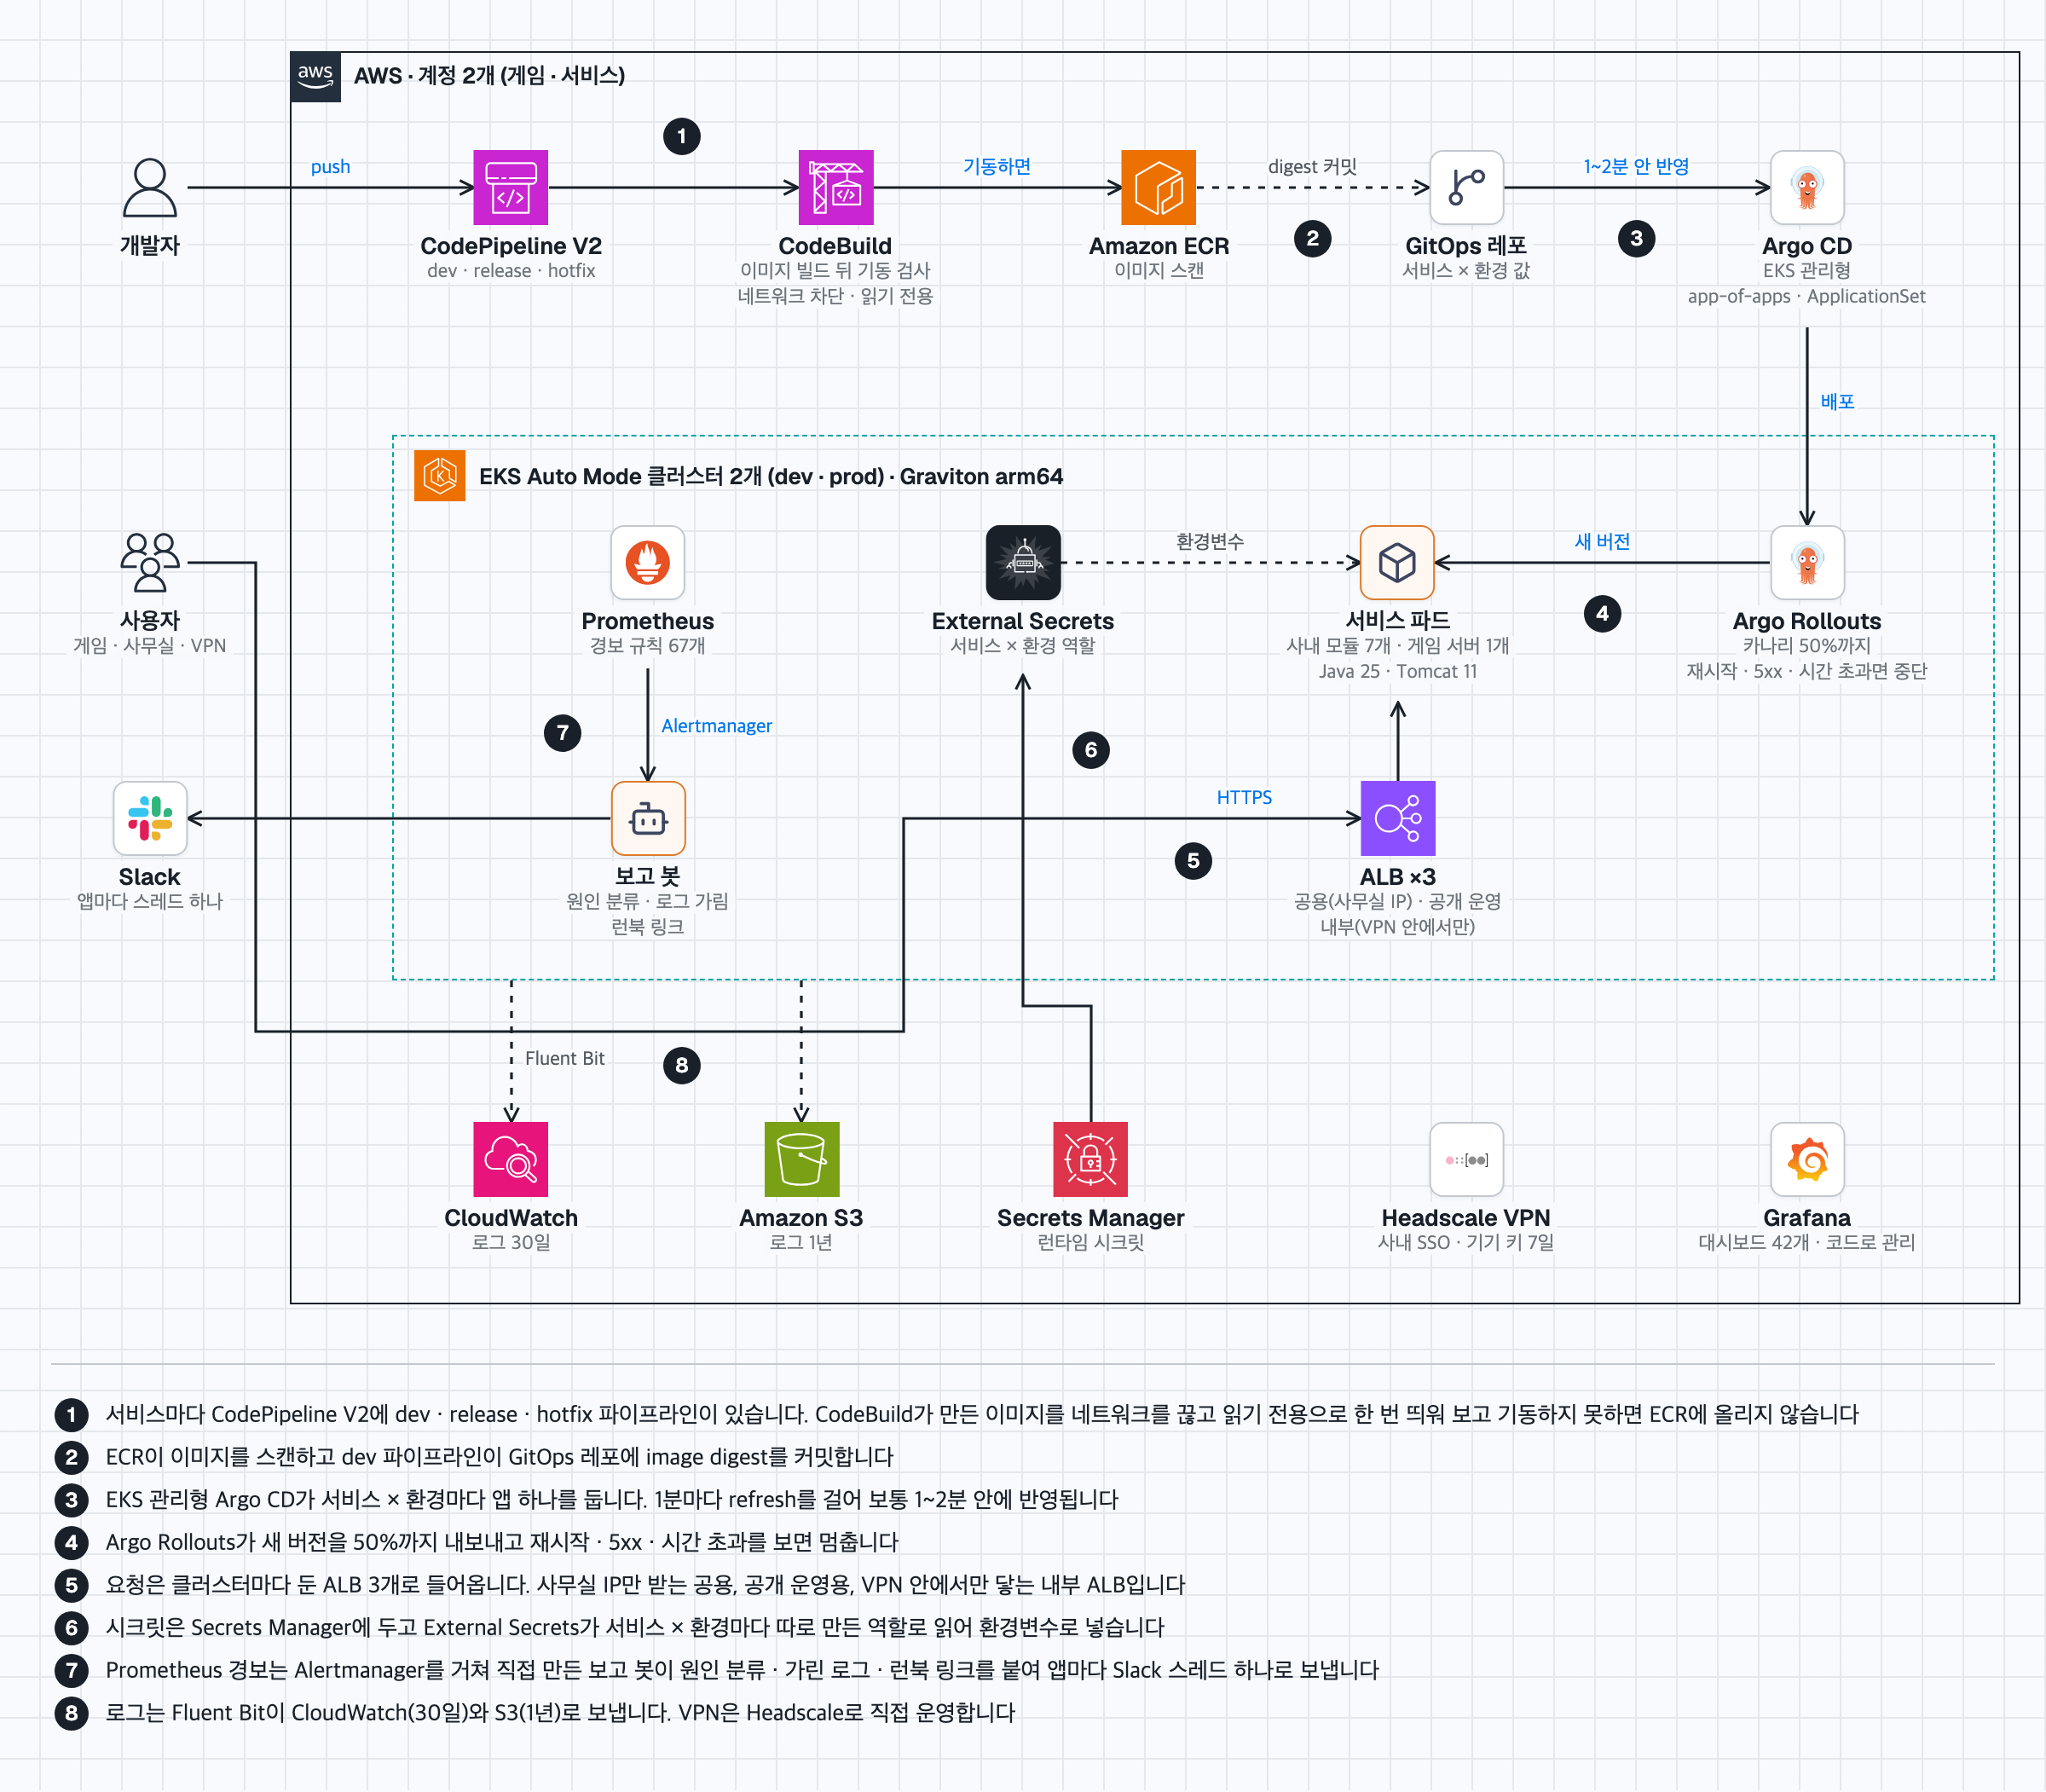
AWS 계정 두 개를 씁니다. 게임 계정에는 레포·파이프라인·ECR·관리형 Argo CD·Grafana·VPN을 모으고, 서비스 계정에는 사내 플랫폼 클러스터를 둡니다. Argo CD는 직접 설치하지 않고 EKS 관리형을 씁니다. 반영이 느린 단점이 있지만 서버 팀이 3명이라 Argo CD 자체를 업그레이드하고 지키는 일까지 떠안고 싶지 않았습니다. Terraform도 계정마다 스택 하나이고 파일 33개, resource 블록 174개(약 4,800줄)입니다.
클러스터 두 개는 EKS Auto Mode에 노드 풀을 직접 정의했고 노드는 모두 Graviton(arm64)입니다. dev는 스팟을 먼저 쓰고, prod는 온디맨드 노드에 taint를 걸어 서비스 파드만 올리며 노드 교체는 평일 오후에만 일어나게 했습니다. 파드 권한은 Pod Identity로, 사람의 클러스터 접근은 Access Entry로 줍니다.
빌드에서 배포까지
서비스마다 CodePipeline V2에 dev·release·hotfix 파이프라인을 둡니다. CodeBuild가 이미지를 만든 뒤 네트워크를 끊고 루트 파일시스템을 읽기 전용으로 둔 채 한 번 띄워 봅니다. 여기서 기동하지 못하면 ECR에 올리지 않습니다. 올린 이미지는 ECR이 스캔하고, dev 파이프라인은 GitOps 레포에 이미지 digest를 커밋합니다.
Argo CD는 EKS 관리형을 씁니다. 플랫폼 앱 25개는 app-of-apps로, 서비스는 ApplicationSet으로 서비스 × 환경마다 앱 하나씩 만들고 차트와 값은 multi-source로 따로 읽습니다. 관리형 Argo CD가 GitOps 레포 변경을 5~28분 늦게 읽어서 1분마다 모든 앱에 refresh를 거는 파드를 따로 두었고, 지금은 보통 1~2분 안에 반영됩니다.
카나리 판정과 배포 기록 조건은 문제 해결 사례에 적었습니다.
인프라 변경 경로
Terraform 적용은 파이프라인을 거칩니다. 읽기 전용 역할로 plan을 만들고, Slack 알림과 수동 승인을 거친 뒤 다른 역할이 저장된 plan 파일을 그대로 적용합니다. 승인을 기다리는 사이 plan이 오래되면 다시 만듭니다.
삭제나 교체가 들어간 plan은 따로 허용하지 않으면 실패하고, 지우면 안 되는 리소스에는 prevent_destroy를 걸었습니다. 파이프라인이 내려받는 terraform 바이너리는 SHA256을 확인하고, 문서만 바뀐 머지는 파이프라인을 건너뜁니다.
접속 경로와 시크릿
클러스터마다 ALB를 셋 둡니다. 사무실 IP만 받는 공용 ALB, 공개 운영용 ALB, VPN 안에서만 닿는 내부 ALB입니다. 사무실과 VPN은 split DNS로 같은 주소를 쓰기 때문에 exit node가 필요 없습니다.
VPN은 Headscale과 Headplane으로 직접 운영합니다. Tailscale SaaS나 AWS Client VPN도 있지만 회사 규모가 크지 않아 사내 접속 경로까지 외부 서비스에 기대는 범위를 줄이고 싶었습니다. 로그인은 사내 SSO(OIDC)로만 되고 기기 키는 7일이면 만료됩니다. ACL은 Git에 두고 API 키는 매일 바꿉니다.
시크릿은 Secrets Manager에 두고, External Secrets가 서비스 × 환경마다 따로 만든 역할로 읽어 파드에 환경변수로 넣습니다.
관측과 경보
Prometheus에 경보 규칙 67개와 recording rule 24개를 두었습니다. Alertmanager는 직접 만든 보고 봇으로 보내고, 봇은 경보마다 원인을 분류해 민감 정보를 가린 로그와 런북 링크를 붙인 뒤 앱마다 Slack 스레드 하나로 모읍니다. Prometheus나 Alertmanager가 죽어 경보가 끊기는 경우는 클러스터 밖 데드맨 알람이 잡습니다.
로그는 Fluent Bit이 CloudWatch(30일)와 S3(1년)로 보냅니다. Grafana 대시보드 42개(패널 약 740개)는 Python 생성기로 만들어 코드로 관리하고, 비용은 OpenCost로, AWS 지표는 YACE로 함께 봅니다.
서버 공용 framework
공용 컴포넌트
모듈마다 따로 짜던 것을 framework에 모았습니다. DB 연결은 HikariCP에 연결·쿼리 타임아웃을 두고, 연결 실패가 5초 안에 3번 나면 차단기를 엽니다. 데이터 오류와 락 대기는 장애로 세지 않습니다. Aurora 장애 조치 뒤 옛 writer를 가리키는 연결은 바로 버립니다.
외부 HTTP는 타임아웃이 있는 공용 클라이언트로만 부르고 주기 작업은 공용 작업 실행기로 돌립니다. 응답 본문은 버퍼에 담았다가 커밋이 성공한 뒤에만 보냅니다. 그 밖에 SQS FIFO 큐(DLQ, 처리 결과 DONE·RETRY_LATER·POISON), Outbox, 참조 데이터 갱신, JSON 한 줄 로그(토큰·키·영수증 마스킹)가 들어 있습니다.
상태 확인은 둘로 나눴습니다. health는 기동과 준비를 보고, live는 데드락·멈춘 요청·주기 작업 박동만 보며 DB는 보지 않습니다. 첫 Ready 뒤에 DB나 Redis가 잠깐 끊기면 degraded로 표시만 해서 파드가 한꺼번에 빠지지 않게 했습니다.
모듈 간 호출 규칙 (gRPC)
모듈끼리는 클러스터 내부 주소의 gRPC로만 부릅니다. 모듈 사이 호출이 잦아 호출 비용을 줄이고 싶었고, 주고받는 메시지 모양이 자주 바뀌지 않아 protobuf로 스키마를 고정해도 부담이 적었습니다. RailNetwork에서 앱과 서버 사이에 gRPC를 붙이며 겪은 판단과 같습니다. deadline은 필수이고 자동 재시도는 하지 않으며 호출 깊이는 한 단계로 제한합니다. DB 세션을 연 채로는 원격 호출을 할 수 없게 막았습니다. 느린 상대가 커넥션을 붙잡아 장애가 번지는 것을 막으려는 규칙입니다.
대상별·서버별 동시 호출 상한을 두고 넘으면 기다리지 않고 바로 거절합니다. 호출마다 JSON 로그와 지표를 남깁니다. 첫 API로 다른 모듈의 결제 테이블에 직접 쓰던 경로를 그 테이블 주인 모듈의 멱등 RPC로 바꿨습니다.
네 가지 보장
모듈을 나누고 장애 대응을 넣을 때는 네 가지를 기준으로 판단합니다. 로그인이 막히지 않을 것, 지급이 늦더라도 빠지거나 두 번 되지 않을 것, 로그가 늦더라도 사라지지 않을 것, DB 부하가 지금보다 늘지 않을 것입니다. 게임이 받는 응답은 바꾸지 않고 새 기능은 /v2 경로로 냅니다.
core에는 DB 장애 때 쓰는 경로를 만들었습니다. 장애 중에는 로그인과 결제를 기기 단위 SQS FIFO 큐에 넣고 평소와 같은 응답을 준 뒤, 복구되면 같은 코드로 한 번만 기록합니다. reward는 멱등 키로 주문·구매·환불이 한 번만 처리되게 했습니다. 두 작업은 로컬 장애 주입 시험을 통과했고, 필요한 DDL을 운영 DB에 적용하기 전이라 작업 브랜치에 있습니다.
검증 방법
모듈을 옮길 때마다 옛 빌드와 새 빌드를 같은 DB에 붙여 같은 요청을 보내고 응답을 비교합니다. 차이가 한 건이라도 나오면 옮기지 않습니다.
공용 컴포넌트와 모듈에는 DB 없이 도는 자체 검사를 붙였습니다(41개 클래스, assert 약 690개). 데드락이나 중복 키 오류로 DB 차단기가 열리면, 아직 커밋되지 않았을 수 있는 id를 커서가 건너뛰면, URL 인코딩된 키 값이 로그에 그대로 남으면 실패합니다.
framework를 바꾼 push는 두 레포의 framework 트리가 같고 자체 검사가 모두 통과해야 나갑니다. 직접 만든 HTTP 클라이언트와 스레드, printStackTrace는 금지 구문 검사가 잡습니다.
레거시에서 찾은 문제 유형과 고친 모양
모듈을 옮기기 전에 레거시 코드를 모듈별로 읽고 반복해서 나오는 문제를 유형으로 묶었습니다. 지금까지 21가지이고, 유형마다 고친 모양을 정해 공용 컴포넌트나 규칙으로 만들었습니다. 새 모듈을 옮길 때는 이 목록부터 찾아봅니다. 아래 표는 그중 일부입니다.
| 찾은 문제 | 대표 예 | 고친 모양 |
|---|---|---|
| 외부 호출 먼저, 커밋 나중 | 게임에 지급 요청을 보낸 뒤 DB 커밋 | 기록 → 커밋 → 호출 순서, 멱등 키로 재시도 |
| 응답을 확인하지 않거나 오류를 삼킴 | 모듈 간 결제 보고, 환불 알림 | 상태를 확인하고 Outbox에 넣거나 공급사 재시도에 맡김 |
| 개수 확인 뒤 insert 경쟁 | 쿠폰·주문 중복 | 유니크 키 + INSERT IGNORE, 조건부 UPDATE |
| 요청 하나에 커밋 여러 번 | 주문 목록 조회가 주문마다 커밋 | 한 트랜잭션으로 묶음 |
| 커서를 처리 전에 저장, 0행이면 커서가 비고 오류 한 번에 작업 정지 | 광고 네트워크 지표 수집 작업 | 결과와 같은 트랜잭션에서 커서 전진, 마지막 성공 시점 − R일부터 다시 수집 |
| Redis를 기준 데이터로 사용 | 요청마다 Redis INCR로 id 발급, Redis가 죽으면 전부 500 | DB를 기준으로 두고 요청 id는 로컬 값으로 대체 |
| 타임아웃 없음 | JDBC socketTimeout 없음, 외부 HTTP 무제한 대기 | DB 타임아웃과 차단기, 공용 HTTP 클라이언트 |
| 직접 만든 스레드, 세션 누수 | new Thread, 커밋 실패 뒤 세션이 남음 | 공용 작업 실행기, 세션 정리 |
| 로그 실패가 본 처리를 깸 | 로그 저장 실패가 결제 500이 됨 | 로그는 따로 커밋하고 실패를 본 처리로 올리지 않음 |
| 행 하나 때문에 전체 실패 | 중복 키·NPE로 기동 중단 | 행 단위로 격리하고 경고 로그, 이전 값 유지 |
| 기동 때 한 번만 읽음 | 새 게임이 재시작 전까지 안 보임 | 참조 데이터 자동 반영 |
| 설정 변경을 서버마다 폴링 | 파드마다 15초 체크섬 조회 | DB 트리거 → 버전 테이블 → 감시자 하나 → Redis pub/sub |
| 다른 모듈 테이블에 직접 쓰기 | 이관 작업이 다른 모듈의 메인 DB에 씀 | 주인 모듈의 gRPC, 또는 주인이 만든 뷰를 읽기 전용 계정으로 조회 |
| readiness가 DB·Redis에 묶임 | DB가 끊기면 로그인 서버의 공개키(JWKS) 응답까지 끊김 | 첫 Ready 뒤에는 degraded 표시만 |
사내 로그인과 권한
OIDC 서버
운영툴 로그인을 맡는 OIDC 서버를 직접 만들었습니다. Keycloak을 띄우거나 Cognito를 쓰는 길도 있었습니다. 필요했던 건 Grafana·사내 VPN 같은 외부 도구를 OAuth 방식으로 붙일 OIDC 제공자 하나였고, 인증까지 AWS에 맡기면 이미 큰 AWS 의존이 더 커집니다. discovery·authorize·token·userinfo·jwks·logout 엔드포인트가 있고 Authorization Code + PKCE(S256)만 받습니다. 토큰은 ES256 JWT이고 access·id 토큰은 10분짜리입니다. RFC 9207(iss 파라미터)과 RFC 9068(JWT access token)을 따릅니다.
refresh 토큰은 쓸 때마다 새로 바꾸고, 이미 쓴 토큰이 다시 오면 그 계열 전체를 끊습니다(10초 유예). refresh를 SSO 세션에 묶어서 로그아웃이나 권한 회수, 계정 비활성화가 10분 안에 모든 도구에 닿습니다. redirect_uri는 정확히 일치해야 하고 서명 키는 kid로 돌려 가며 바꿉니다. 새 도구는 코드 수정 없이 데이터 등록만으로 붙습니다.
권한 계산
권한은 원장 하나에서 계산합니다. 팀에 붙은 도구와 그 사람이 맡은 게임을 곱하고 개인 예외를 더하는 방식입니다. 개인 예외에는 사유를 꼭 남기고, 마지막 남은 최고 관리자는 회수할 수 없습니다. 권한을 바꾸면 감사 기록을 같은 트랜잭션에서 씁니다. 권한을 다루는 관리 콘솔 화면(JavaScript 약 2천 줄)도 함께 만들었습니다.
도구로 권한 전달
중앙 서버는 사람·팀·도구 단위까지만 알고 세부 권한은 각 모듈에 있습니다. 도구 목록은 모듈이 10분마다 가져가고, 권한 변경은 중앙이 이벤트로 밀어 주며, 하루 한 번 전체를 맞춰 봅니다. 중앙이 보내는 호출에는 60초짜리 서명 JWT를 붙이고 모듈이 서명과 대상, 수명을 검증합니다.
이벤트는 transactional outbox에 쌓고 사람마다 단조 증가하는 순번을 붙입니다. 모듈은 시계를 비교하지 않고 이 순번으로 순서와 중복을 판단합니다. 전달은 at-least-once이고 실패하면 10초에서 1시간까지 간격을 늘려 다시 보냅니다. 4xx가 오면 멈추고, 한 도구가 실패해도 다른 도구 전송은 계속됩니다. 권한이 바뀌면 그 도구의 로그인 세션만 30초 안에 끝납니다.
외부 콘솔 권한 동기화
Play Console·Firebase·App Store Connect 권한도 원장을 기준으로 맞추는 동기화 작업을 만들었습니다. 모드는 off·read·write 세 가지이고, 기본인 read는 차이만 기록하고 바깥 쓰기는 하지 않습니다. dev에서는 write로 설정해도 읽기만 합니다.
두 작업이 동시에 돌지 않도록 lease와 fencing token을 씁니다. 권한을 옮길 때는 먼저 더하고 나중에 빼서, 중간에 옛 권한과 새 권한을 합친 범위보다 넓어지지 않게 했습니다. 결과를 알 수 없는 호출은 '알 수 없음'으로 따로 기록합니다. 한 번에 많이 회수하려 하면 차단기가 멈추고, 적용할 plan은 해시로 승인합니다.