RailNetwork-JP (일본 철도 실시간 API)
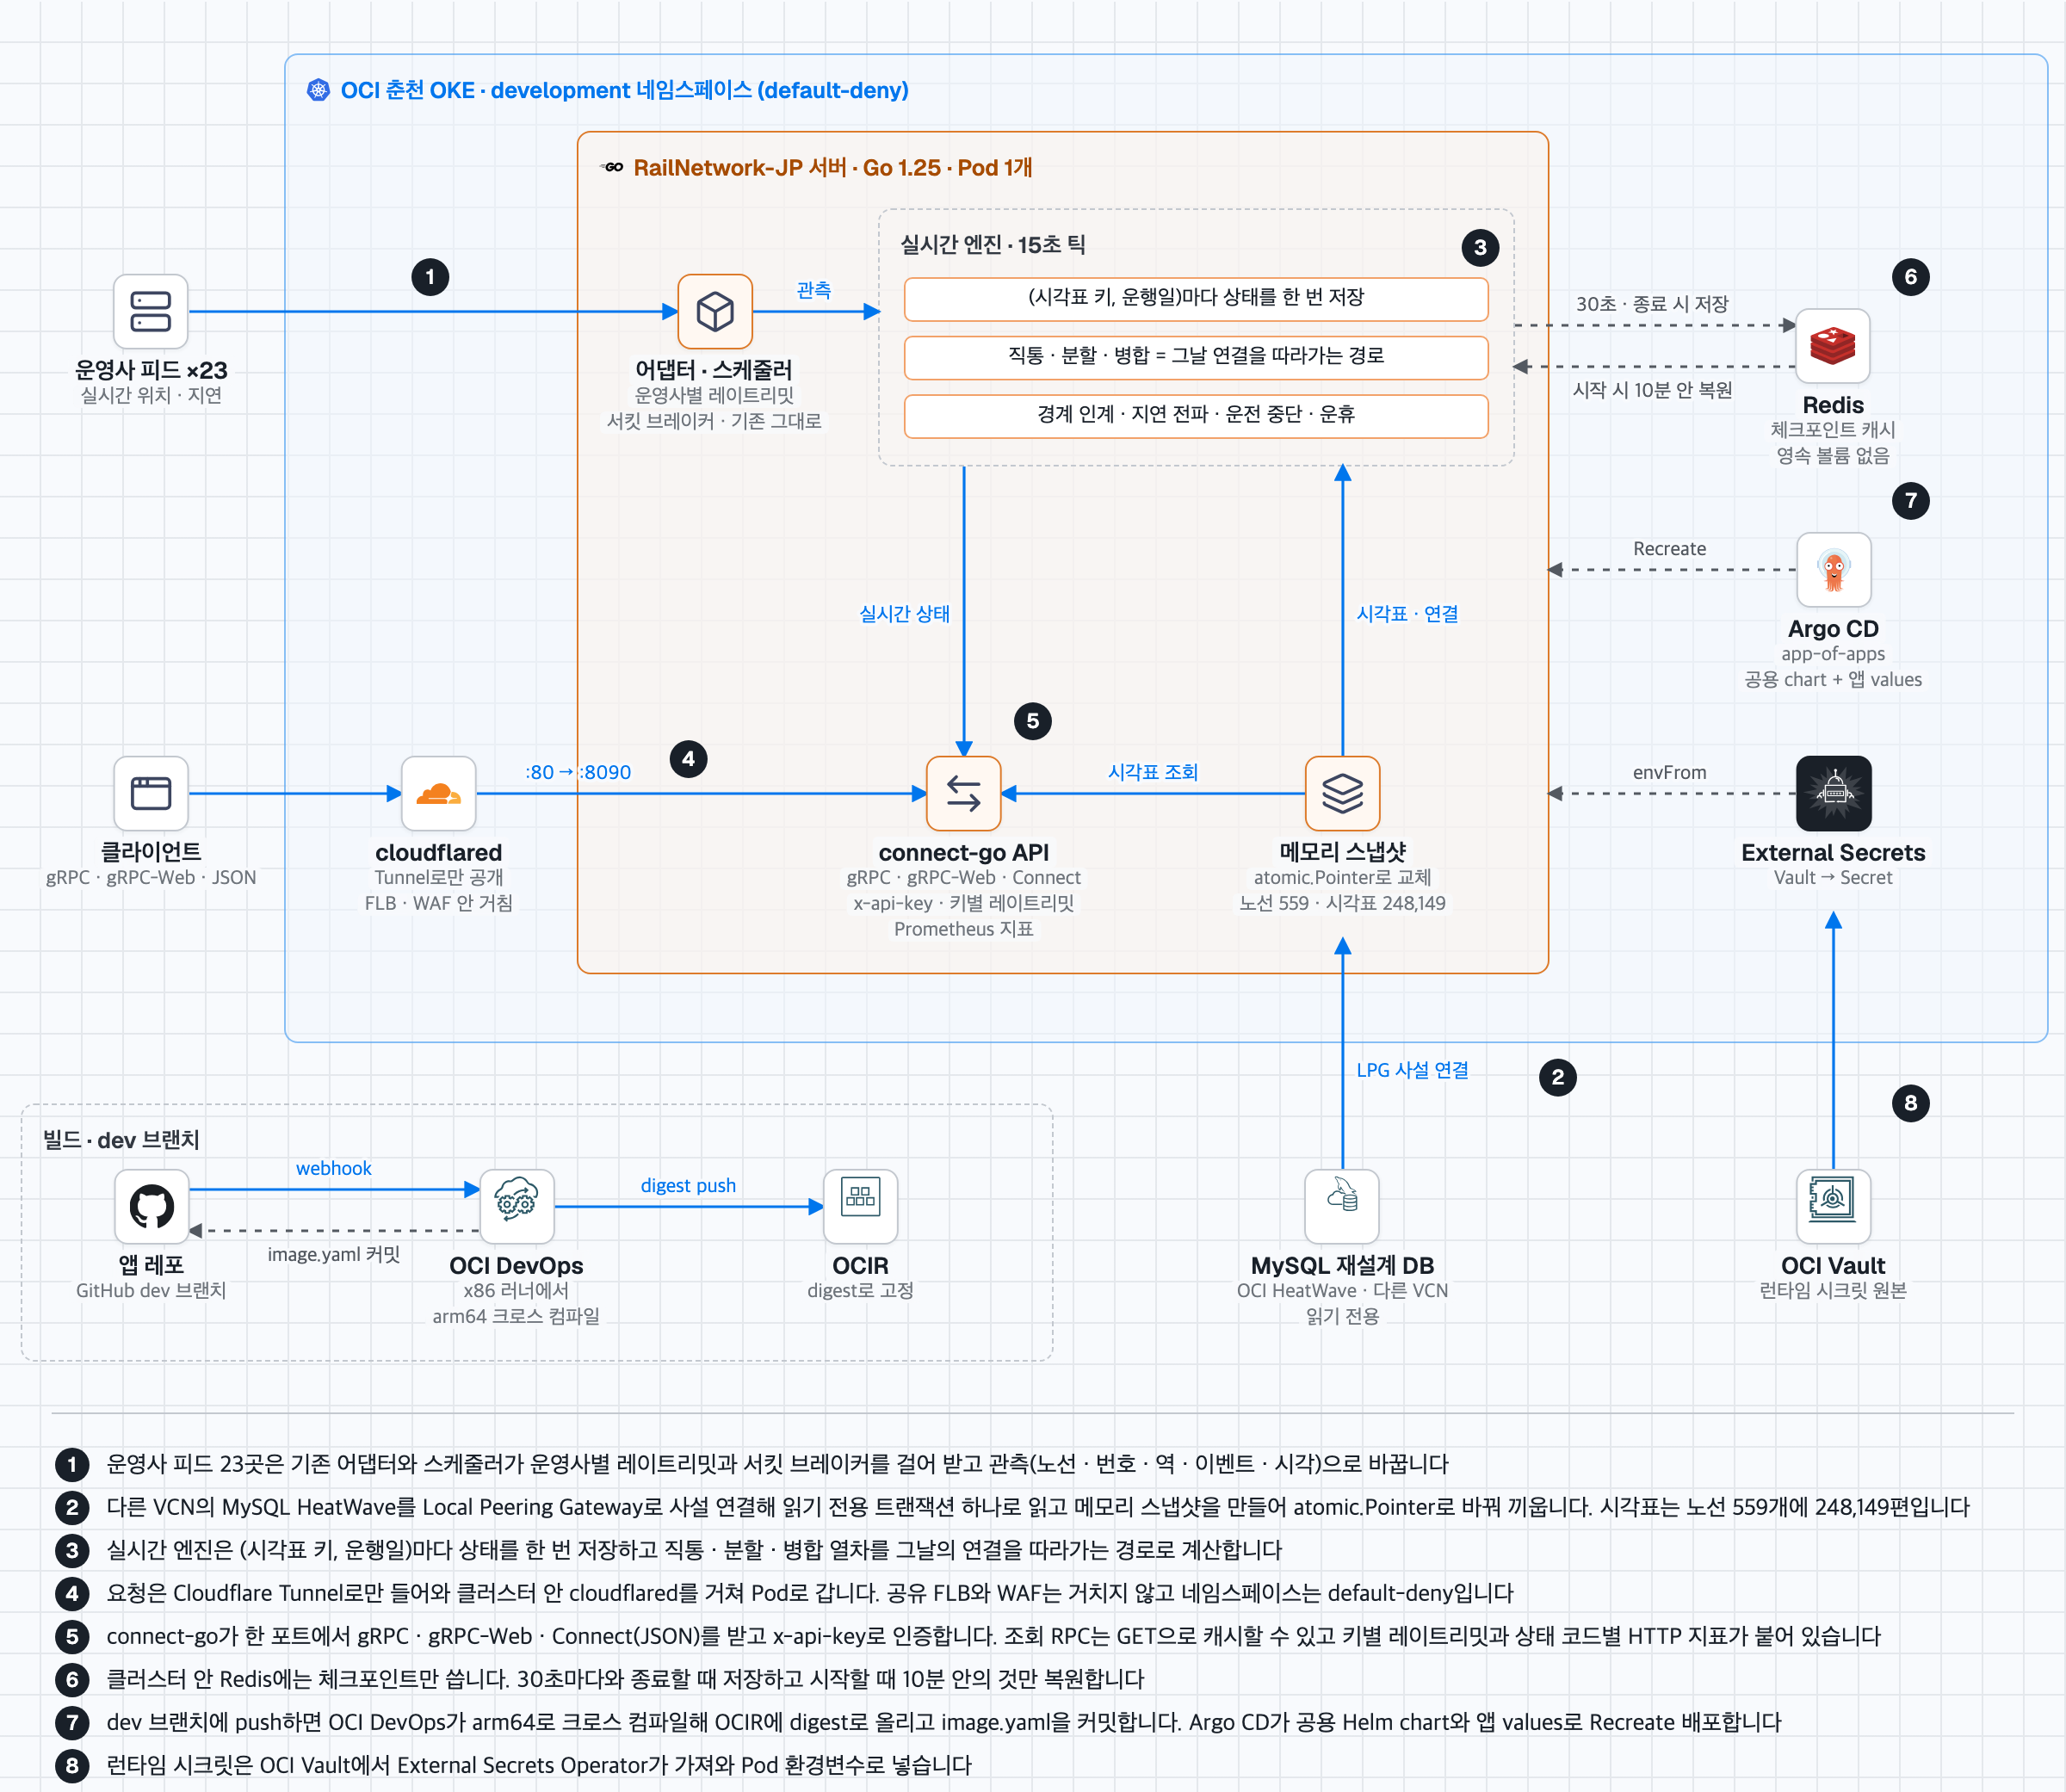
일본 철도 시각표와 실시간 열차를 내보내는 Go 서버를 다시 설계하고 있습니다. 지금은 OKE development 환경에서만 돌립니다. 재설계한 MySQL DB의 노선 단위 시각표를 읽기 전용으로 메모리 스냅샷에 올리고 운영사 피드에서 받은 열차 위치(관측)를 그 시각표에 붙입니다. 회사 경계를 넘는 직통 열차는 연결을 따라 한 편으로 보여 줍니다. API는 connect-go로 gRPC·gRPC-Web·Connect(JSON)를 한 포트에서 받습니다.
- 상태
- 개발 중
- 기간
- 2026.05 – 현재
- 역할
- 1인 개발
- 기술
- Go 1.25, connect-go (gRPC · gRPC-Web · Connect), Protocol Buffers, MySQL · OCI HeatWave (읽기 전용), Redis 7.4 (실시간 상태 체크포인트), Prometheus, Docker, OCI OKE · Argo CD · Cloudflare Tunnel, Python (시각표 적재·정제 스크립트)
- 시각표
- 248,149편
- 직통·분할·병합 연결
- 57,579건
- 시각표 적재
- 44.9→10.5s
주요 성과
- JR동일본 실데이터 01:10 표본 1,419편에서 계획에 붙은 비율이 매칭 보정 전 20%에서 56%가 됐습니다. 21%는 첫차 대기 열차로 알아봤고 23%는 추가 열차(대부분 심야 9xxx 임시)였습니다(재설계 서버)
- 힌트로만 들어온 직통 연결 7,419건 중 327건이 스냅샷 단계에서 대상 시각표에 이어지고 アクセス特急은 나리타공항→하네다공항이 한 경로가 됩니다(재설계 서버)
- 시각표 적재를 44.9초에서 10.5초로 줄였습니다(시각표 243,848편)
- OKE development에서 live heap은 약 240MB이고 GOGC=50으로 RSS가 400~430MiB에 머뭅니다. Pod 메모리 한도는 1536Mi입니다
- 설계 결정 78건을 ADR로 남겼습니다
담당 작업
- 재설계 DB의 시각표를 읽기 전용 트랜잭션 하나로 읽어 메모리 스냅샷을 만들고
atomic.Pointer로 바꿔 끼웁니다. 요청은 DB에 닿지 않습니다. 게시 신호나 소스 테이블이 바뀐 것을 확인했을 때만 다시 적재합니다. - 시각표 API(역 출발 안내·시각표·직통 구간 조회·노선 목록)와 실시간 API(열차·노선별 열차·노선 스트림)를 connect-go로 한 포트에 냅니다. 조회 RPC는 GET으로도 받아 CDN이 캐시할 수 있습니다.
- 실시간 상태를 (시각표, 운행일) 단위로 한 번만 저장하는 엔진을 만들었습니다. 직통·분할·병합 열차는 그날의 연결을 따라가는 경로로 계산합니다. 경계 인계, 지연 전파, 운전 중단·운휴를 이 모델 위에서 처리합니다.
- 기존 어댑터와 스케줄러(운영사별 레이트리밋·서킷 브레이커)는 그대로 두고 관측만 새 엔진에 넣습니다. 운행번호만 주는 피드, 번호를 주지 않는 피드, 페이지 순서로 키를 매기는 피드는 운영사별 정책으로 받습니다.
- 재시작해도 실시간 상태가 이어지도록 30초마다 Redis에 체크포인트를 쓰고 종료할 때도 씁니다. 시작할 때 10분 안의 체크포인트만 복원합니다.
- 운행번호 하나로 모든 노선에서 달리는 열차를 찾는 FindTrains RPC를 붙였습니다. 운행정보 피드(도쿄메트로, 나고야시영지하철)는 규제 구간과 함께 받아 열차 상태에 싣습니다.
- 같은 열차를 여러 소스가 알려 주면 JR 공식 사이트, JR 앱, 운영사 소스 순으로 믿습니다. JR 앱은 요일 그룹마다 대표일 하루만 받아서 특정 날에만 다니는 임시열차가 빠지기 때문입니다. JR 시각표는 날짜별로 따로 둡니다.
- API 키별 레이트리밋(초당 20회, 순간 40회)과 Prometheus 지표(상태 코드별 HTTP 요청 시간 포함)를 붙였습니다. 헬스 체크는 스냅샷을 올리기 전까지 503을 돌려줍니다.
- 열차마다 법적 노선과 별도로 운행계통을 내보냅니다. 야마노테선이 법적 노선인 구간을 달리는 사이쿄선·소테쓰 직통 열차를 그 계통 이름으로 보여 줍니다.
- 기존 서버는 운영사 19곳의 피드를 어댑터 27종으로 받아 Redis의 실시간 상태와 MySQL 시각표를 합쳐 REST·gRPC·SSE로 내보내고 직통 열차는 피드의 직통 표식과 시각 매칭으로 추론해 잇습니다.
- 다시 설계한 이유는 기존 DB였습니다. 2026.09.12 읽기 전용 감사에서 정차시각 3,029,353행 중 227,935행이 어느 사업자의 역 마스터에도 없는 역을 가리켰고, 노선 마스터에 없는 노선을 가리키는 시간표도 4,398건이었습니다. 재설계 서버에서는 기존 server·dia-worker와 그 둘만 쓰던 패키지 25개를 지웠습니다. main과 마지막 운영 배포본에는 기존 서버가 남아 있습니다.
문제 해결 사례
제목을 누르면 접근과 결과가 펼쳐집니다.
정차시각 22.8만 행이 어느 역 마스터에도 없는 역을 가리키던 DB
기존 DB를 읽기 전용으로 감사했습니다(2026.09.12, 전체 저장분 기준). 정차시각 3,029,353행 중 227,935행이 어느 사업자의 역 마스터에도 없는 역을 가리켰습니다. 노선 마스터에 없는 노선을 가리키는 시간표는 4,398건이었습니다. 역 ID는 사업자 범위 안에서만 유효한데, 그 범위를 잃은 마스터가 섞여 있었습니다. 그래서 같은 ID가 다른 사업자에 있다는 것만으로는 맞는 참조인지 판정할 수 없었습니다. 열번·요일·출처를 문자열로 합친 내부 ID도 많았습니다.
기존 DB를 읽기 전용으로 감사했습니다(2026.09.12, 전체 저장분 기준). 정차시각 3,029,353행 중 227,935행이 어느 사업자의 역 마스터에도 없는 역을 가리켰습니다. 노선 마스터에 없는 노선을 가리키는 시간표는 4,398건이었습니다. 역 ID는 사업자 범위 안에서만 유효한데, 그 범위를 잃은 마스터가 섞여 있었습니다. 그래서 같은 ID가 다른 사업자에 있다는 것만으로는 맞는 참조인지 판정할 수 없었습니다. 열번·요일·출처를 문자열로 합친 내부 ID도 많았습니다.
접근
고쳐 쓰지 않고 DB를 다시 설계했습니다. 역은 물리역 하나로 두고 사업자·노선 소속과 역 번호는 따로 둡니다. 시간표 편은 한 노선에 속합니다. 정차의 노선 소속은 복합 FK로 강제합니다. 내부 ID는 숫자로 바꾸고 외부 식별자는 별칭 테이블에 둡니다. 원본은 한 곳에 보관하고 시간표마다 복사하지 않습니다.
이관은 별도 DB에서 했고 운영 연결은 바꾸지 않았습니다. 기존 스키마가 그대로 복구 지점입니다.
결과
기존 72개 테이블 16,848,796행을 새 DB에 옮기고 행 수와 해시를 다시 확인했습니다. 지금은 역명·위치·공식 노선 대응으로 정제를 이어 가고 있습니다. 확인되지 않은 달력과 경계는 게시하지 않습니다.
회사를 넘어 달리는 열차를 열차번호만 보고 이으면 무관한 열차가 한 주행이 된다
직통 열차는 회사가 바뀌는 경계에서 번호를 유지하기도 하고 바꾸기도 합니다. 기존 서버는 상대 구간 번호가 확인되지 않아도 번호를 경계 너머로 이은 적이 있었습니다. 그 결과 JR의 K·H 번호 열차에 확인되지 않은 소테쓰 구간이 붙었습니다. 번호만으로는 회사가 다른 두 열차가 같은 열차인지 알 수 없습니다.
직통 열차는 회사가 바뀌는 경계에서 번호를 유지하기도 하고 바꾸기도 합니다. 기존 서버는 상대 구간 번호가 확인되지 않아도 번호를 경계 너머로 이은 적이 있었습니다. 그 결과 JR의 K·H 번호 열차에 확인되지 않은 소테쓰 구간이 붙었습니다. 번호만으로는 회사가 다른 두 열차가 같은 열차인지 알 수 없습니다.
접근
기존 서버는 직통 표식·상대 구간 힌트·시각으로 열차를 체인에 배정하고 편성 충돌·경계역 불일치·시간 역순이면 잇지 않습니다. 근거가 모자라면 tentative로 내보내고 다음 틱에 물려주지 않습니다.
재설계 서버는 상대 번호를 실시간에서 추론하지 않습니다. 시각표 데이터에는 경계마다 다음 시각표나 다음 노선·번호가 들어 있고 관측은 그 연결을 따라서만 회사 경계를 넘습니다. 상대 노선에 보고 중인 실시간 소스가 있으면 그 노선에서 열차가 보일 때까지 인계를 확정하지 않습니다.
결과
재설계 엔진의 인계 규칙(유예 뒤 미확인, 소스 없는 노선은 예측, 다음 회사가 경계에서 보고하면 앞 구간 종료)과 운전 중단·운휴 처리를 고정 입력 테스트로 남겼습니다. 기존 체인 엔진의 섀도 비교 수치는 '직통운행 구현'의 마지막 절에 있습니다.
전체 열차 조회가 Redis 키 7,800개를 읽어 3MB JSON을 만든다
기존 서버는 전체 열차 목록을 만들 때 Redis 키 약 7,800개를 MGET으로 읽고 디코드·보강·직렬화를 거쳐 3MB 안팎의 JSON을 만듭니다. 한 번 만드는 데 수 초가 걸리는데 캐시 TTL이 2초여서 2-OCPU 서버에서 재생성이 연달아 돌았습니다. 업스트림 갱신 주기가 15초라 그렇게 자주 만들어도 더 새로운 데이터가 나오지 않습니다.7.8k키 · 3MB 응답
기존 서버는 전체 열차 목록을 만들 때 Redis 키 약 7,800개를 MGET으로 읽고 디코드·보강·직렬화를 거쳐 3MB 안팎의 JSON을 만듭니다. 한 번 만드는 데 수 초가 걸리는데 캐시 TTL이 2초여서 2-OCPU 서버에서 재생성이 연달아 돌았습니다. 업스트림 갱신 주기가 15초라 그렇게 자주 만들어도 더 새로운 데이터가 나오지 않습니다.
접근
TTL을 데이터 갱신 주기에 맞춰 10초로 올리고 stale-while-revalidate로 바꿨습니다. 캐시가 있으면 오래된 사본이라도 먼저 돌려주고 재생성은 백그라운드에서 한 번만 돌립니다. gzip도 재생성할 때 한 번 만들어 두고 압축을 받는 클라이언트에게 그대로 내보냅니다.
재생성이 실패하면 캐시에 쓰지 않아 마지막 정상 응답이 계속 나갑니다. 요청이 와야만 재생성되는 구조라 느리게 폴링하는 클라이언트는 자기 폴링 간격만큼 오래된 사본을 받게 됩니다. 최근 1분 안에 요청이 있었던 슬롯만 백그라운드로 데워서 이 경우에도 지연이 TTL 근처에 머물게 했습니다.
결과
재생성은 한 번만 돌고 그동안에는 이전 응답이 그대로 나갑니다.
server와 dia-worker가 같은 열차 키를 동시에 고치면 한쪽 쓰기가 사라진다
기존 서버에서는 server가 실시간 위치를, dia-worker가 예정 시각표를 같은 Redis 열차 키에 씁니다. 두 프로세스가 각각 읽고-고치고-쓰면 나중 쓰기가 상대의 갱신을 덮습니다. 재현한 순서는 이렇습니다. dia-worker가 새 시각표를 만드는 사이 server가 새 위치를 씁니다. 이때 server가 들고 있던 시각표는 직전 tick의 오래된 사본입니다. 그대로 쓰면 새 위치는 남고 새 시각표가 사라집니다.
기존 서버에서는 server가 실시간 위치를, dia-worker가 예정 시각표를 같은 Redis 열차 키에 씁니다. 두 프로세스가 각각 읽고-고치고-쓰면 나중 쓰기가 상대의 갱신을 덮습니다. 재현한 순서는 이렇습니다. dia-worker가 새 시각표를 만드는 사이 server가 새 위치를 씁니다. 이때 server가 들고 있던 시각표는 직전 tick의 오래된 사본입니다. 그대로 쓰면 새 위치는 남고 새 시각표가 사라집니다.
접근
두 경로 모두 Redis WATCH 트랜잭션으로 감쌌습니다. 감시 중인 키가 바뀌면 읽기부터 다시 하도록 최대 8회 재시도하게 했습니다. 병합 규칙도 명시했습니다. dia-worker는 planned 시각표만 다시 병합하고 위치·지연·실적 필드는 건드리지 않습니다.
열차번호 별칭이 다른 키를 가리키도록 바뀌는 경우도 감시 대상에 넣어서 별칭이 옮겨간 사이에 낡은 키로 쓰는 일이 없게 했습니다.
결과
두 쓰기를 겹치게 만든 회귀 테스트가 통과합니다. 조회 결과에 새 위치와 새 시각표가 둘 다 남아 있어야 하고 둘 중 하나라도 이전 값이면 실패합니다. 8회 안에 커밋하지 못하면 조용히 넘어가지 않고 충돌 오류를 반환합니다.
피드 하나가 타임아웃에 걸리면 나머지 18곳의 수집도 밀린다
운영사 피드는 응답 시간과 레이트리밋이 제각각입니다. 한 수집 루프에서 순서대로 돌면 느린 한 곳이 전체 주기를 늘립니다.
운영사 피드는 응답 시간과 레이트리밋이 제각각입니다. 한 수집 루프에서 순서대로 돌면 느린 한 곳이 전체 주기를 늘립니다.
접근
운영사마다 독립 goroutine과 독립 서킷 브레이커를 뒀습니다. 주기는 기존 서버에서는 DB 런타임 설정 → 정적 설정 → 어댑터 권장값 순으로 고르고 재설계 서버에서는 운영사 설정 파일 값이나 어댑터 권장값을 씁니다. 그다음 최소 간격과 지터를 적용합니다.
한 운영사 안에서 여러 하위 피드를 쓰는 어댑터는 부분 실패를 그대로 표현합니다. 성공한 노선만 반영하고 해당 소스의 health를 degraded로 기록합니다. 실패한 하위 피드가 맡은 노선은 '열차가 없다'로 단정하지 않아서 수집 실패가 열차 소실로 번지지 않습니다.
결과
기존 서버는 도쿄메트로·도에이·도큐·오다큐·도부 5곳에 주 피드가 연속 실패하면 대체 소스를 깨우는 예비 쌍을 둡니다. 예비 소스는 평소에는 돌지 않아 상대 API 호출 한도를 쓰지 않습니다. 재설계 서버의 수집은 같은 스케줄러를 쓰지만 예비 쌍은 쓰지 않습니다.
레포 파일을 읽고 내린 진단이 서버가 읽는 값과 달랐다
운영사 설정·직통 체인·역·번역은 레포 파일과 DB 양쪽에 있고 어느 쪽을 읽을지는 환경변수가 정했습니다. 배포된 서버는 넷 다 DB를 읽는데 문제를 볼 때는 레포 파일을 열어 봤습니다.
세이부 직통 체인이 붙지 않는 원인을 파일에서 찾아 노선 ID를 고쳤습니다. 그런데 서버가 읽는 DB에는 이미 그 값이 들어 있었고 체인은 여전히 0건이었습니다. 파일은 실제로 틀렸고 그 판단도 맞았지만 서버 동작에 대한 결론은 틀렸습니다. 서버가 그 파일을 읽은 적이 없기 때문입니다.신칸센 0 → 88편
운영사 설정·직통 체인·역·번역은 레포 파일과 DB 양쪽에 있고 어느 쪽을 읽을지는 환경변수가 정했습니다. 배포된 서버는 넷 다 DB를 읽는데 문제를 볼 때는 레포 파일을 열어 봤습니다.
세이부 직통 체인이 붙지 않는 원인을 파일에서 찾아 노선 ID를 고쳤습니다. 그런데 서버가 읽는 DB에는 이미 그 값이 들어 있었고 체인은 여전히 0건이었습니다. 파일은 실제로 틀렸고 그 판단도 맞았지만 서버 동작에 대한 결론은 틀렸습니다. 서버가 그 파일을 읽은 적이 없기 때문입니다.
접근
DB 핸들을 여는 프로세스에서는 DB를 런타임 원본으로 정하고 파일은 시드 입력으로만 쓰기로 해서 ADR로 남겼습니다. 각 카탈로그의 소스 환경변수를 명시하지 않거나 오타가 있으면 경고가 아니라 부팅 실패로 처리합니다. 예전에는 빈 값이든 오타든 파일 기본값으로 조용히 넘어갔습니다.
파일을 DB로 반영하는 시드 도구는 먼저 차이를 출력하고 기본값은 dry-run으로 뒀습니다. 실제로 전체 시드를 그냥 돌렸다면 JR서일본 45개 노선과 게이오 4개 노선이 지워졌을 텐데 이 dry-run이 그걸 먼저 잡았습니다.
결과
마이그레이션이 신칸센 노선 ID에서 운영사를 뗄 때 운영사 런타임 테이블에는 반영되지 않았습니다. 그래서 배포 서버에서 신칸센이 0편으로 보이던 일이 있었습니다. 원인을 DB 쪽에서 찾아 고친 직후 88편이 표시됐습니다(기록 당시 관측).
직통운행 구현
재설계한 서버 기준입니다. 마지막 절은 기존 서버의 구현입니다.
시각표의 직통 연결
재설계 서버는 시각표를 노선 단위로 두고 직통은 시각표 사이의 연결로 표현합니다. 연결 한 건에는 앞 시각표와 경계 정차 순번, 경계역, 다음 시각표, 운행일 차이, 종류(직통·분할·병합)가 들어 있습니다. 다음 시각표를 특정하지 못한 연결은 다음 노선과 열차번호만 적은 힌트로 둡니다. 시각표는 노선 559개에 248,149편입니다. 연결은 시각표가 243,848편일 때 세어 57,579건이었습니다.
실시간 상태는 (시각표 키, 운행일) 단위로 한 번만 저장합니다. 시각표 키는 노선·번호·방향·정차역 순서·첫 예정 시각의 해시라서 DB를 다시 적재해도 바뀌지 않습니다. 승객이 보는 열차 한 편은 그날의 연결을 따라가는 경로로 그때그때 계산합니다. 분할하는 열차는 갈래마다 한 편이 되고 앞부분 상태는 갈래끼리 공유합니다.
DB에는 대상 시각표가 있는데도 힌트로 들어온 연결이 있습니다(게이큐 본선→공항선). 스냅샷을 만들 때 힌트 노선에서 번호가 같고, 경계역에서 출발하고, 같은 날 운행하고, 도착 30분 안에 떠나고, 다른 연결이 들어오지 않는 시각표가 하나뿐이면 그 시각표에 잇습니다. 힌트 7,419건 중 327건이 이렇게 이어졌고 アクセス特急은 나리타공항→하네다공항이 한 경로가 됐습니다.
경계역을 시각 없이 지나는 열차도 있습니다(선라이즈의 도요하시·마이바라, 긴테쓰 059의 이세나카가와). 인계에는 시각이 필요해서 이런 정차는 앞뒤의 시각 있는 정차 사이를 직선 거리 비율로 나눠 시각을 정합니다.
관측을 시각표에 붙이는 규칙
어댑터 관측은 소스, 노선, 번호, 번호 종류, 역, 이벤트, 시각으로 이뤄집니다. 운행일은 관측 시각에서 03:00을 뺀 JST 날짜이고 그날과 전날 계획에서 같은 노선의 같은 번호를 찾습니다. 다음 날 01:10 관측이 전날 25:10 예정 열차에 붙는 것도 이 규칙 때문입니다. 관측 시각에서 알려진 지연을 뺀 값이 그 역 예정보다 10분 넘게 이르거나 90분 넘게 늦으면 후보에서 뺍니다.
후보가 여럿이면 행선지와 종별로 좁힙니다. 가장 가까운 후보가 다음 후보보다 15분 이상, 그리고 두 배 이상 가까울 때만 붙입니다. 같은 번호가 60분 간격으로 도는 야마노테선에서 맞는 바퀴를 고르는 기준입니다. 그래도 남으면 어디에도 붙이지 않고 모호 건수만 셉니다. 신고한 노선에 그 번호가 없으면 그 역을 지나는 다른 노선에서 찾습니다(우에노도쿄라인·쇼난신주쿠라인은 출발 노선 이름으로 신고됩니다).
피드가 직통 열차를 한 노선 이름으로 계속 보고하기도 합니다(게이세이는 アクセス特急을 오시아게선 구간에서도 스카이액세스선으로 보고합니다). 붙인 구간이 그 역을 지나지 않으면 연결을 앞뒤로 최대 4번 따라가 그 역을 지나는 구간으로 옮깁니다. 번호가 계획에 없으면 같은 번호로 30분 안에 붙었던 구간의 다음 구간을 먼저 봅니다(하루카 1007M이 한와선 역에서 보고되는 경우).
어디에도 붙지 않은 번호는 추가 열차가 됩니다. 이때 힌트 하나가 그 노선의 그 번호를 기다리고 있고 경계 예정 시각과 90분 안이면 앞 구간에서 이 열차로 직통 연결을 만듭니다(근거 hint, 신뢰도 medium). 운행 중 번호가 바뀌면(列番変更) 바뀐 번호를 남기고 그날 그 노선에서는 새 번호로도 찾습니다. 경계에서 번호가 바뀌는 직통은 다음 시각표에 그 번호가 이미 있으므로 실시간에서 번호를 추론하지 않습니다.
테스트는 01:10 관측이 전날 25:10 계획에 붙는지, 15분·두 배 기준에 못 미치는 두 후보가 모호로 남는지, 다음 구간이 그 역을 지나지 않을 때 연결로 찾는지, 힌트로 만든 추가 열차가 앞 구간 열차의 끝에 붙는지를 고정합니다. JR동일본 실데이터 01:10 표본 1,419편에서는 계획에 붙은 비율이 보정 전 20%에서 56%가 됐습니다. 21%는 첫차 대기 열차로 알아봤고 23%는 추가 열차(대부분 심야 9xxx 임시)였습니다.
경계 인계와 지연 전파
15초 틱마다 운행 중인 구간을 확인합니다. 경계역 예정 시각에 현재 지연과 유예 5분을 더한 시각이 지나면 다음 구간을 봅니다. 다음 구간이 이미 관측됐으면 인계가 끝난 것으로 보고 앞 구간을 종료합니다. 다음 회사 피드가 경계역에서 열차를 보고하거나 다음 구간에서 경계를 떠난 관측이 오면 유예를 기다리지 않고 앞 구간을 끝냅니다(소테쓰가 하자와요코하마코쿠다이에서 6277을 보고하면 JR 277M 구간이 끝납니다).
다음 노선에 실시간 소스가 있고 그 노선이 최근 10분 안에 보고했는데 이 열차가 보이지 않으면 다음 구간을 미확인(unconfirmed)으로 표시하고 운행 중으로 만들지 않습니다. 직통 운행이 중지된 날 상대 노선에 없는 열차를 그리지 않으려는 규칙입니다. 구독만 되어 있고 아무것도 보고하지 않는 노선은 확인할 수단이 없다고 보고 예측으로 넘깁니다. 병결 상대가 보고된 경우(고마치를 하야부사 번호로 보고)는 본 것으로 칩니다.
다음 노선에 실시간 소스가 없으면 다음 구간을 예측(predicted) 상태로 운행 중에 두고 지연을 그대로 넘깁니다. 인계도 관측도 없이 앞 구간의 예정 종료 시각에서 지연과 30분이 더 지나면 그 구간은 unknown이 됩니다.
관측이 들어오면 연결과 병결을 따라 아래쪽 구간에 지연을 예측값으로 내립니다. 분할 뒤에는 두 갈래 모두에, 병합 뒤에는 들어오는 지연 중 큰 값을 씁니다. 자기 관측이 있는 구간은 덮어쓰지 않습니다. 그래서 경계 너머 구간도 상대 회사 피드가 보고하기 전까지 앞 회사의 지연으로 예상 시각을 냅니다.
테스트는 보고 중인 노선에서 유예 전에는 미확인이 아니고 유예 뒤에는 미확인이면서 운행 중이 아닌지, 소스 없는 노선에서는 예측으로 넘어가고 앞 구간이 끝나는지, 구독만 된 조용한 노선에서는 예측으로 넘어가는지, 시각 없는 경계역 때문에 출발 1분 만에 인계되지 않는지를 고정합니다. 지연 300초가 직통·분할 구간에는 예측으로, 병결 상대에는 관측으로 들어가는지도 확인합니다.
직통 운행 중지와 운전 중단
운전 중단(打ち切り)은 열차의 마지막 정차 순번을 바꿔 기록합니다. 그 정차 뒤에서 나가는 연결은 따르지 않으므로 그날의 열차는 거기서 끝나고 다음 구간은 스스로 시발이 됩니다. 운휴는 구간 전체나 어느 역 이후를 미래 날짜까지 취소할 수 있습니다. 취소는 위쪽 구간으로 번지지 않고 아래쪽 구간은 도중역 시발이 됩니다.
직통 운행 중지는 그날의 계획 연결에 중지 표시를 다는 함수로 처리합니다. 중지된 연결은 경로와 지연 전파에서 빠지므로 양쪽이 별개의 열차가 됩니다. 이 함수에는 전용 테스트가 없습니다.
지금 수집기가 엔진에 넘기는 것은 위치·지연·종별·회송 여부·열차 이름·행선지·편성입니다. 운전 중단·운휴·직통 중지 공지를 엔진에 넣는 수집 경로는 없습니다. 그래서 직통이 중지된 날 상대 노선의 유령 열차를 막는 것은 앞 절의 미확인 규칙뿐이고 이 규칙은 상대 노선에 보고 중인 실시간 소스가 있을 때만 작동합니다.
테스트는 경계 직전 정차에서 운전 중단을 받으면 열차가 짧은 운행 하나로 끝나는지, 가운데 구간을 운휴시키면 앞 구간은 혼자 남고 분할 갈래는 스스로 시발이 되는지를 고정합니다.
기존 서버의 체인 엔진과 섀도 비교
기존 서버는 직통을 실시간에서 추론합니다. 운영사 피드의 직통 표식과 상대 구간 힌트, 첫 출발 ±2분 시각 매칭으로 열차를 체인에 배정합니다. 경계 인계는 편성 충돌·경계역 불일치·시간 역순을 먼저 거른 뒤 점수로 판정합니다. 근거가 모자라면 잇지 않거나 tentative로 내보내고 다음 틱에 물려주지 않습니다. 재설계 서버에는 이 코드가 없고 main과 마지막 운영 배포본에는 기존 서버가 남아 있습니다.
상대 구간 번호가 확인될 때만 인계를 확정하는 엔진을 섀도로 붙여 운영 서버의 판정 2,919건을 비교했습니다. 87.3%는 같았고 나머지 12.7%(371건)는 전부 체인 엔진만 이은 경우였습니다. 사철끼리만 달리는 구간에서는 1,789건 중 318건(17.8%), JR이 낀 구간에서는 1,115건 중 35건(3.1%)이었습니다. 사철 직통은 경계에서 번호가 그대로라 당시 데이터에는 상대 구간 번호가 따로 남지 않았습니다.
재설계는 상대 번호를 실시간에서 찾지 않고 시각표 데이터의 연결에서 받습니다. 경계마다 다음 시각표나 다음 노선·번호가 있어야 상대 회사 관측을 이 열차의 다음 구간으로 붙입니다. 연결이 없으면 번호나 시각만으로 회사 경계를 넘겨 잇지 않습니다.
일본 철도 도메인 문제
운영사 간 역 ID 충돌
직통 경계를 역 ID로 판정하려면 그 ID가 어느 회사 것인지부터 알아야 합니다. A07은 도에이 센가쿠지(泉岳寺)이면서 긴테쓰 가와치에이와(河内永和)이고 니시테쓰 오제키(大堰)이기도 합니다. 경계 정의에 역 ID만 두면 세 역이 같은 경계로 붙습니다.
기존 서버의 YAML 체인 정의에는 경계 역 ID를 가진 운영사를 함께 적고 충돌하는 ID를 고정 입력으로 넣은 테스트를 남겼습니다. 기존 서버가 읽는 DB 경계 테이블에는 그 컬럼이 없어서 운영사마다 다른 역을 뜻하는 코드 9행은 추정해 고치지 않고 없는 ID로 남겼습니다. 추정이 틀리면 경계가 엉뚱한 역으로 굳기 때문입니다. 재설계 DB는 경계역을 운영사 코드가 아닌 역 행의 정수 ID로 가리킵니다.
경계에서의 열차번호 변경
직통 열차는 회사가 바뀌는 지점에서 번호도 같이 바뀝니다. JR도카이 4600K가 JR동일본 구간에서 121M이 되고 다시 3121이 되는 열차는 구간 3개에 경계 2개입니다.
기존 서버는 관측되지 않은 구간의 번호를 추론합니다. 살아 있는 형제 열차의 번호로 채우면 4600K→4600K 같은 가짜 무변화가 생겨서 상대 번호를 모를 때는 빈 값으로 둡니다. 서버가 내부에서 합성한 syn: 식별자도 응답에 내보내지 않습니다. 재설계 서버는 경계마다 연결에 다음 시각표가 들어 있어 다음 구간 번호를 그 시각표에서 읽습니다.
계획·예측·실적 시각 분리
재설계 서버는 정차마다 계획·예상·실적 시각을 따로 냅니다. 계획은 항상 시각표 스냅샷에서 오고 예상은 관측된 지연으로 계산하며 실적은 그 실적을 처음 쓴 소스만 고칠 수 있습니다. 열차 단위로는 관측(observed)인지 예측(predicted)인지를, 정차 단위로는 ok·inaccurate·no_data 품질을 함께 냅니다. 계획 시각은 운행일 기준 초라서 자정을 넘기는 열차도 순서가 유지됩니다. 기존 서버는 예측 시각마다 근거 소스를 함께 냅니다.
수집이 끝난 열차 정리
피드에서 한 번 빠졌다고 바로 지우면 일시적인 누락에도 열차가 사라집니다. 재설계 서버는 소스가 정상인데 10분 동안 보고가 없으면 unknown으로 둡니다. 소스가 장애일 때는 조용하다는 이유만으로 바꾸지 않습니다. 계획에 없는 추가 열차는 끝낼 기준이 없어서 15분 침묵이면 unknown이 됩니다.
종착역 도착을 받으면 운행 종료로 넘깁니다. 피드는 도착 직후 열차를 빼는 경우가 많아서 예정 종료에 지연을 더한 시각이 지난 뒤 소스가 정상인데 10분 넘게 조용해도 종료로 봅니다. 그래도 남은 구간은 예정 종료 30분 뒤에 끝냅니다. 실시간 상태는 운행일 이틀이 지나면 메모리에서 지웁니다. 기존 서버는 2분간 보이지 않으면 소실로, 종착 확인 뒤 5분이 지나면 운행 종료로 둡니다.
운영사별 데이터 품질 차이
운영사별 capability tier
운영사마다 피드가 증명할 수 있는 것이 다릅니다. 열차별 상태를 직접 주는 곳도 있고 노선 단위 운행정보만 주는 곳도 있습니다. 기존 서버는 어댑터 경계에서 이 차이를 capability tier로 선언하고 응답에 그대로 싣습니다.
19곳 중 S 7곳, A 6곳이고 나머지 6곳은 B·C·F입니다. C·F 등급은 열차 단위 실시간을 만들 수 없어서 응답에 운영사 공식 페이지 주소를 넣고 클라이언트가 자체 UI 대신 그 페이지를 열도록 했습니다. fallback_url이 있으면 등급은 반드시 C 또는 F라는 조건을 API 문서의 불변식으로 적어 뒀습니다. 재설계 서버의 API에는 이 필드가 없습니다.
열차번호를 주지 않는 피드
기존 서버는 난카이·긴테쓰·JR서일본·오다큐처럼 열차번호가 없는 피드에서 운영사·노선·방향·영업일 종별·출발 시각으로 식별자를 합성하고 train_id_confidence: synthetic으로 표시합니다.
재설계 서버는 메이테쓰·오사카메트로처럼 번호를 주지 않는 피드를 시각과 행선지로 계획에 붙입니다. 신고 역에서 지연을 반영한 시각에 가까운 계획 출발 가운데 행선지가 피드의 행선지 문구와 맞는 것을 찾습니다. 하나로 정해질 때만 붙입니다. 붙인 뒤에는 피드 자체의 키로 같은 계획에 계속 두고 추가 열차로 만들지 않습니다.
설계 결정
connect-go를 쓴 이유와 대가
기존 서버는 Go 1.22의 ServeMux로 REST 라우트를 처리하고 공통 로그·인증·오류 처리를 미들웨어로 직접 만들었습니다. 재설계 서버는 같은 ServeMux에 connect-go 핸들러를 얹었습니다. 한 핸들러가 gRPC, gRPC-Web, Connect를 같은 포트에서 받고 모든 조회 RPC를 부수 효과 없음으로 선언해 GET으로도 받습니다. 시각표 응답에는 5분 동안 공개 캐시할 수 있는 헤더를 붙입니다.
대가는 속도입니다. 공개된 벤치마크에서 connect-go는 grpc-go보다 느립니다. 요청 경로가 메모리 조회뿐이라 받아들였습니다. 클라이언트 쪽 부하 분산(xDS)도 없어서 L7 프록시가 맡아야 합니다.
실시간 상태와 기준 정보의 저장 위치
시각표 DB는 처음에 PostgreSQL로 계획했지만 OCI 프리티어에는 관리형 PostgreSQL이 없어 Always Free에 들어가는 MySQL HeatWave로 바꿨습니다. 기존 서버는 활성 열차 상태와 변경 알림 Pub/Sub을 Redis에, 노선·역·시각표·직통운행 설정을 MySQL에 둡니다. 재설계 서버는 시각표·노선·역을 MySQL에서 읽기만 하고 메모리 스냅샷으로 올립니다. 실시간 상태는 프로세스 메모리에 두고 쓰기는 잠금 하나 아래에서만, 읽기는 잠금 없이 합니다.
Redis는 30초마다 상태를 저장했다가 재시작할 때 10분 안의 체크포인트를 복원하는 데만 씁니다. OKE development에서 live heap은 약 240MB이고 GOGC=50으로 RSS가 400~430MiB에 머뭅니다. 한도는 GOMEMLIMIT 1300MiB, Pod 1536Mi입니다.
레포를 둘로 나눴다가 다시 합친 이유
처음에는 DB 스키마와 정적 데이터를 Python 레포에서 관리하고 Go 서버는 읽기만 했습니다. 스키마가 바뀔 때마다 두 레포의 PR과 배포 순서를 맞춰야 했고 서버가 아직 없는 컬럼을 읽는 일도 생겼습니다.
혼자 관리하는 규모에서는 분리 비용이 더 커서 Python 파이프라인을 이 레포 안으로 합치고 마이그레이션도 Go 레포로 옮겼습니다. 대신 이전 레포가 남긴 schema_migrations.version = 329 때문에 새 마이그레이션은 0330부터 번호를 붙여야 합니다. 더 작은 번호는 러너가 이미 처리한 것으로 보고 건너뜁니다. 그래서 이 규칙을 README와 해당 마이그레이션 주석에 남겼습니다.
시스템 아키텍처
수집에서 전달까지
기존 서버는 운영사마다 독립 goroutine과 독립 서킷 브레이커로 피드를 받아 Redis의 활성 열차 상태를 갱신하고 변경을 Redis Pub/Sub 채널로 올립니다. 각 서버의 Hub가 이 채널을 구독해 노선별 SSE·gRPC 구독자에게 전달하고 예정 시각표는 dia-worker가 따로 채웁니다.
재설계 서버는 같은 스케줄러로 피드를 받습니다. 수집기가 각 열차 상태를 재설계 DB의 노선·역 ID로 바꾼 관측으로 만들어 실시간 엔진에 넣습니다. 엔진은 15초 틱마다 인계·종료·침묵을 처리합니다. 시각표는 메모리 스냅샷에서 조회합니다. 노선 스트림은 처음에 전체 목록을 보낸 뒤 바뀐 구간만 보내며 20초 안에 한 번은 하트비트를 보냅니다.