RailNetwork
서울 지하철 열차 위치와 운행 정보를 보여 주는 서비스입니다. 2023년부터 운영해 왔고 지금은 2인 팀에서 백엔드와 인프라를 맡고 있습니다. 외부 공공 데이터 보정, 스토어에 나가 있는 앱과의 응답 호환 유지, 배포 중 열차 상태 보존이 주요 작업이었습니다. 2026년에는 JavaScript·Express 서버를 TypeScript·Fastify·gRPC로 옮겼습니다.
- 상태
- Production
- 기간
- 2023.07 – 현재
- 역할
- 백엔드·인프라 담당 · 2인 팀
- 기술
- Node.js 20, TypeScript, Fastify 5, gRPC, Server-Sent Events, MongoDB, Redis, SHA-256 요청 해시 · 타임스탬프 · Nonce 검증, Flutter (MVVM · ko/en/ja), watchOS · iOS 홈 위젯, GitHub Actions (Play 배포), Jenkins (TrainAccAPI), Winston, Prometheus, Firebase Analytics, Docker, OpenAPI 3.0 · Swagger UI, node:test · 계약 스냅샷 · 패리티, OCI ARM VM · Portainer · Cloudflare · Tailscale
- 월간 총 사용자 (GA4, 2026.10.01~27)
- 7,693
- 같은 달 비교 (2025.10→2026.10)
- 2.2배
- p95 · k6 부하 테스트 (v1 REST→v2 gRPC)
- 143→42ms
- 앱 광고 노출 (AdMob, 2026.09)
- 145만 회
- 앱 공개 노선
- 25
주요 성과
- 2026.10 총 사용자는 27일까지 7,693명으로 월 단위 최고치입니다. 1년 전 같은 달(2025.10) 3,420명의 2.2배이고 2025.09 3,035명부터 한 번도 줄지 않았습니다(GA4 사용자 획득 보고서, 월 단위 총 사용자, 2026.10.28 조회). 유료 광고 없이 Organic Search·Direct 유입으로 늘었습니다
- 앱 광고(AdMob)는 2026.09 한 달 요청 414만 회, 노출 145만 회, 일치율 63.12%였습니다. 1년 전 같은 달(2025.09)에는 광고 기록이 없습니다
- 2026.09.29~10.26 28일 동안 총 사용자 7,797명, 재방문 6,174명, DAU/MAU 24.1%, 활성 사용자당 평균 참여 시간 52분 50초였습니다. 직전 측정(2026.08.08~09.04)은 활성 사용자 5,997명 중 재방문 87.5%, DAU/MAU 29.0%였습니다
- 라이브 부하 실측(k6 v0.54, 2026.09.05): 같은 시나리오에서 p95 v1 REST 143ms → v2 gRPC 42ms, 서버 이벤트루프 지연 p99 51.5ms → 21.2ms, 실패 0건. 프로토콜·응답 스키마·전송 경로가 함께 바뀐 채로 비교했습니다
- 1호선 계획 전송을 10분마다 256.8KB에서 하루 1회 20.6KB로 줄였습니다(앱 실측, 개발 서버, gzip, 2026.09.04). 같은 날 6노선 시간표는 gzip REST 575KB·316ms 대비 gRPC 383KB·58ms였습니다
- 자동 테스트가 0개였던 서버에 계약·단위 테스트와 ADR을 남겼습니다. 2026.09.18 기준 test/ 아래
*.test.*파일은 166개(계약 18·단위 148), ADR은 8편입니다. v1 응답은 바이트 단위로 동결해 스토어 앱이 그대로 호출하고 있습니다 - 코레일 일반열차 역 통과 판정을 OSM 선로거리 기반으로 바꿨습니다. 56,202개 fix 재생(2026.08.29)에서 '지나간 선로거리 구간 안의 역' 기준 커버리지는 KTX 94%·ITX 100%로 기존 2차원 방식과 같습니다. 선로거리 방식으로는 점프 구간 역의 시각을 보간하고 계획과 실제 경로의 불일치를 검출하는 데서 이득을 봤습니다
- RAPTOR 경로 탐색은 2026.10.01 가지치기 뒤 최단시간 p50이 144ms → 33ms로 줄었고 질의 120개의 결과는 모두 그대로였습니다. 최대 환승 기본값을 3회로 올린 2026.10.05 측정(질의 30개 × 출발 3시각)은 p50 22ms입니다
- 2026.08.20 51분 장애 뒤 swap·워치독·캐시 상한·알림 4개·런북을 추가했습니다. 새 임계값을 당시 I/O 대기 곡선에 대입하면 붕괴 25분 전에 경고 조건에 닿는 것으로 계산했습니다
- 앱 공개 25개 노선을 10초 간격으로 갱신하고 있고 blue-green 단일 flip으로 전환합니다. 2026.08.30 00:38 0.0.30 전환은 lb·redis를 건드리지 않고 끝났습니다
담당 작업
- 기존 지하철 앱들이 공공 열차 데이터를 받는 요청 형식과 헤더를 확인해 노선별 수집 로직을 정리했습니다.
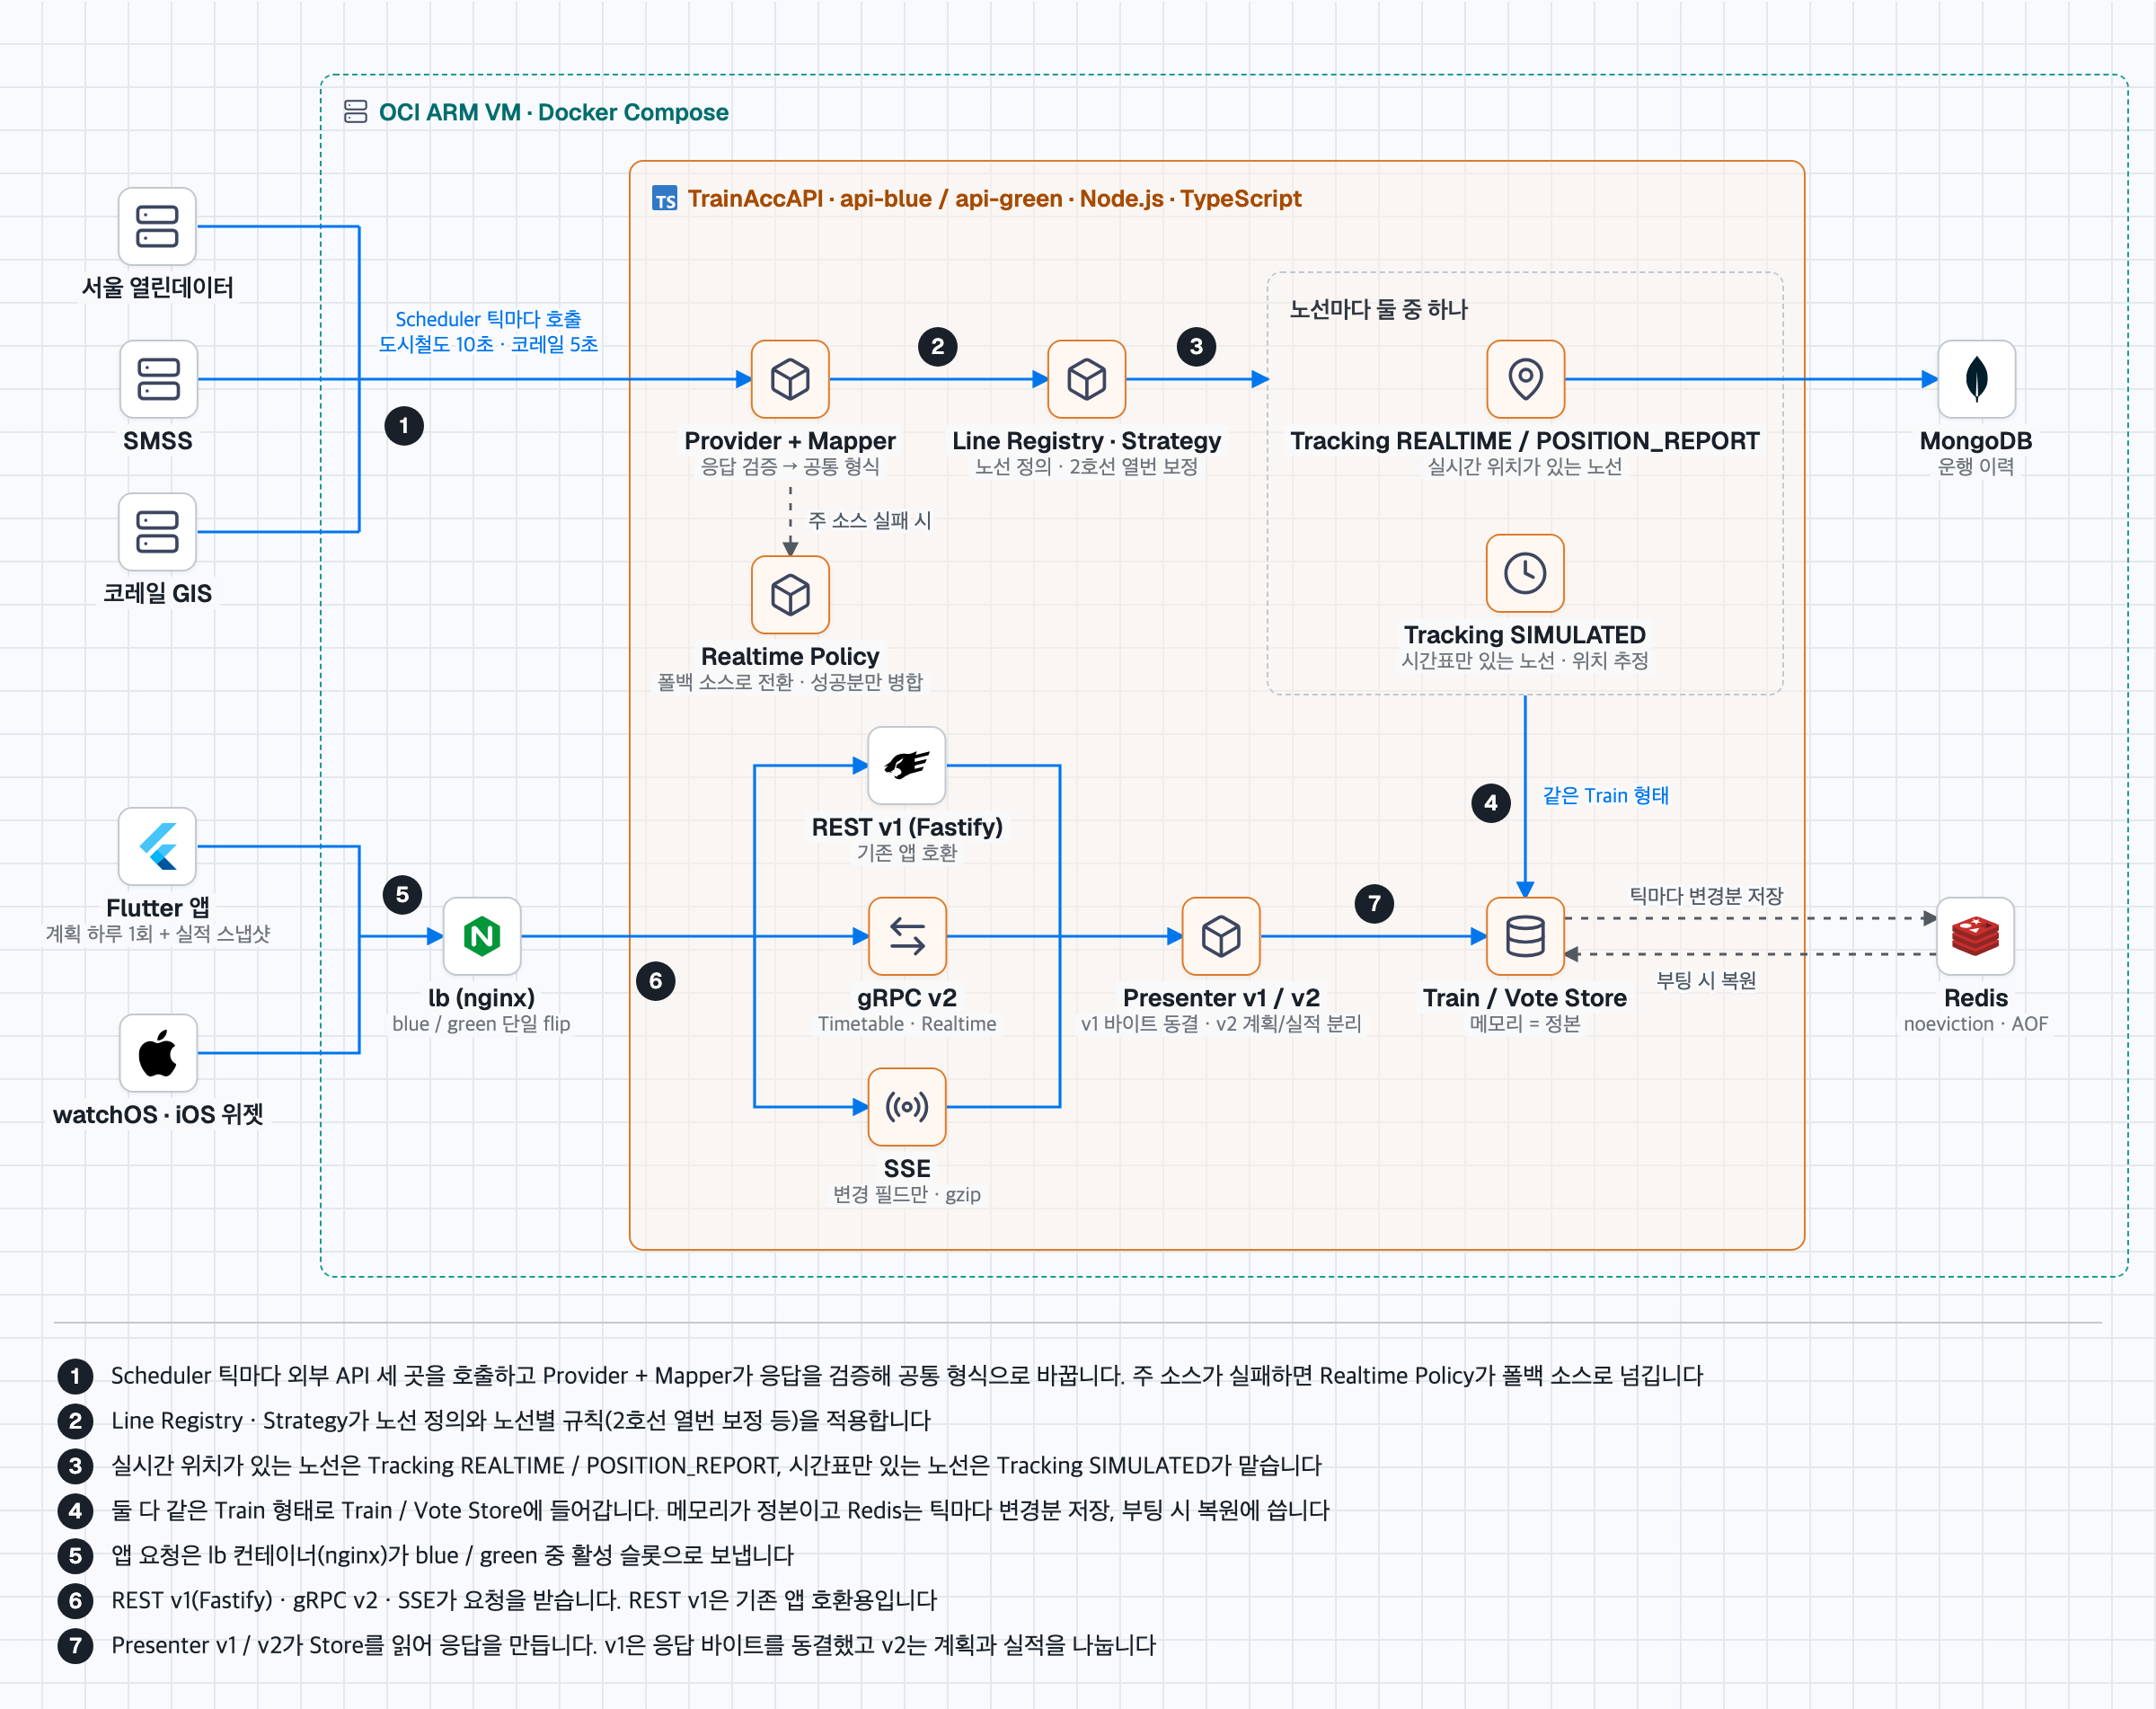
- 서울시 열린데이터를 주 소스로 사용하고 SMSS(서울교통공사 실시간 열차 API)는 행선지 보완과 장애 시 폴백에 쓰도록 구성했습니다. 서로 다른 응답은 같은 형식으로 변환해 나머지 코드가 데이터 출처를 신경 쓰지 않게 했습니다.
- 2호선은 지연이 생기면 열번이 바뀌는데 두 API 응답을 병합하고 중복을 제거한 뒤 노선 규칙에 맞게 열번을 보정했습니다.
- 공공 API에 없는 편성 정보는 사용자가 제보하고 다른 사용자가 투표로 확인하는 기능으로 보완했습니다.
- 리팩터링 전에 노선·소스별 특수 규칙 115개(SP 22·LP 29·DM 64, 8개 파일 전수 조사)를 목록으로 만들고 기존 응답과 헤더를 테스트로 고정했습니다. 그다음 apicall.js와 trainService.js의 책임을 Provider·Policy·Registry·Strategy·Domain으로 나누고 TypeScript와 Fastify 5로 옮겼습니다.
- Train/Vote Store의 상태를 Redis에 매 틱 저장하고 서버가 시작할 때 다시 읽도록 바꿨습니다. 재시작 뒤에도 열차와 편성 상태를 이어서 사용할 수 있습니다.
- 운영사 11곳의 공지 게시판을 하루 세 번 확인해 새 글만 메일로 보내는 timetable-notifier를 만들었습니다. 사이트별 설정은 YAML 한 파일에서 관리합니다.
- 서비스를 이어받은 직후 한 달간 Flutter 앱·watchOS 앱·iOS 위젯의 배포와 장애 대응까지 혼자 맡았습니다. 클라이언트 동료가 복귀한 뒤에는 proto 계약·압축 헤더·폴백 기준 같은 서버 계약을 설계해 앱 연동을 지원하고 있습니다.
문제 해결 사례
제목을 누르면 접근과 결과가 펼쳐집니다.
라이브 부하 실측으로 v1 REST와 v2 gRPC를 같은 시나리오에서 비교
v2가 빨라졌다는 근거가 개발 서버 단건 측정뿐이었습니다. 라이브 호스트는 dev 컨테이너와 2코어를 공유해 부하를 잘못 걸면 사용자에게 바로 영향이 갑니다.p95 143→42ms
v2가 빨라졌다는 근거가 개발 서버 단건 측정뿐이었습니다. 라이브 호스트는 dev 컨테이너와 2코어를 공유해 부하를 잘못 걸면 사용자에게 바로 영향이 갑니다.
접근
부하 생성기(k6)를 대상 호스트 밖 관측 서버에 두고 앱과 같은 경로(api.railnetwork.kr, Cloudflare 경유)로 넣었습니다. p95가 1초를 넘거나 실패율이 5%를 넘으면 자동 중단하는 가드를 걸었습니다. 새벽 시간대에 v1과 v2에 같은 시나리오(모의 클라이언트, 계획 1회 + 10초마다 실적)를 줬습니다.
결과
이 시나리오의 p95는 v1 REST 143ms, v2 gRPC 42ms였고 서버 이벤트루프 지연 p99는 51.5ms에서 21.2ms로 줄었습니다. 전 시나리오에서 실패는 0건이었고 라이브 health 응답은 최대 53ms였습니다.
v1과 v2 사이에서는 프로토콜(REST→gRPC)·응답 스키마(계획/실적 분리)·전송 경로가 함께 바뀌었으므로 한 가지 변경의 효과로 읽을 수 없습니다. 계획 채널은 요청률이 달라 비교에서 제외했습니다. dev 컨테이너는 v1 계획 부하에서 가드 발동 직후 종료돼 용량 계획 과제로 남겼습니다(2026.09.05).
Redis 소켓만 보고 200을 주던 /health/ready, 상태 소유권부터 다시 정의
기존 문서는 Redis를 열차 상태의 단일 소스라고 불렀지만 실제 코드는 요청·SSE·gRPC가 전부 프로세스 메모리를 읽고 Redis에는 틱이 끝난 뒤 변경분만 썼습니다. 이 어긋남 때문에 /health/ready가 Redis 소켓만 보고 200을 줬습니다. 복원이 실패해 스토어가 비어도 '준비됨'이었고 'API replica를 늘리면 된다'는 결론까지 나왔습니다.
기존 문서는 Redis를 열차 상태의 단일 소스라고 불렀지만 실제 코드는 요청·SSE·gRPC가 전부 프로세스 메모리를 읽고 Redis에는 틱이 끝난 뒤 변경분만 썼습니다. 이 어긋남 때문에 /health/ready가 Redis 소켓만 보고 200을 줬습니다. 복원이 실패해 스토어가 비어도 '준비됨'이었고 'API replica를 늘리면 된다'는 결론까지 나왔습니다.
접근
첫 ADR을 소유권 선언으로 썼습니다. 메모리가 정본이고 Redis는 틱마다 쓰는 내구성 체크포인트입니다. 이 문서를 게이트로 삼아 health를 ready·degraded·failed 세 상태로 나눴습니다.
Redis가 끊겼지만 명시적 fresh-start면 degraded(ready=true), 복원을 시도했는데 실패하면 failed(ready=false), 복원이 끝났고 의존성이 살아 있으면 ready입니다.
결과
복원 실패가 '준비됨'으로 새는 경로가 없어졌습니다. replica 논의는 근거가 사라져 종료됐습니다. 이후 하드닝 작업은 ADR-0001을 기준으로 판단하고 있습니다.
2026년 8월 20일 운행 이력 조회 장애 (51분)
운행 이력 조회 한 건이 상한 없는 find().sort()로 317만 건을 전수 스캔하며 142초를 썼습니다(docsExamined 3,172,453 · nreturned 101). 인덱스는 _id_ 하나뿐이었습니다.
상한 없는 WiredTiger 캐시가 메모리를 밀어내 가용 1.9GB·swap 0인 호스트가 I/O 대기에 빠졌습니다. 하드웨어 워치독은 펌웨어에서 꺼져 있어 51분 동안 스스로 복구하지 못했습니다. 재부팅 뒤 같은 질의가 힙 2GB를 26분에 걸쳐 채우고 FATAL로 죽었는데 /metrics에 힙 지표가 없어 그동안 신호가 없었습니다. 커널 오류나 OOM 킬러 기록은 없었습니다.
운행 이력 조회 한 건이 상한 없는 find().sort()로 317만 건을 전수 스캔하며 142초를 썼습니다(docsExamined 3,172,453 · nreturned 101). 인덱스는 _id_ 하나뿐이었습니다.
상한 없는 WiredTiger 캐시가 메모리를 밀어내 가용 1.9GB·swap 0인 호스트가 I/O 대기에 빠졌습니다. 하드웨어 워치독은 펌웨어에서 꺼져 있어 51분 동안 스스로 복구하지 못했습니다. 재부팅 뒤 같은 질의가 힙 2GB를 26분에 걸쳐 채우고 FATAL로 죽었는데 /metrics에 힙 지표가 없어 그동안 신호가 없었습니다. 커널 오류나 OOM 킬러 기록은 없었습니다.
접근
당일 상한 없는 find를 막는 쿼리 가드(5초 타임아웃)와 이력 인덱스를 넣고 /metrics에 힙 사용량·상한 지표를 추가했습니다. 호스트에는 swap 4GB, softdog 워치독(60초), WiredTiger 캐시 상한 3GB, 로그 회전, 문제 경로 nginx 차단을 넣었습니다.
알림 임계값은 사고 당시 I/O 대기 곡선(평소 9~12ms/s → 809 → 2,310 → 4,873ms/s)에서 역산했습니다.
결과
디스크 91% → 71%, 가용 메모리 1.9GB → 7.9GB. 디스크 I/O 지연 알림 2개(0.5s/s·10m, 2s/s·3m)와 앱 알림 2개(힙 85%·의존성 다운)를 걸었습니다.
새 임계값을 당시 곡선에 대입하면 0.5s/s 경고는 붕괴 25분 전, 2s/s 심각은 11분 전에 조건에 닿습니다. 사고 로그로 사후에 계산했습니다. Alertmanager가 그때 실제로 발화했는지를 재현한 것도, 이후 장애에서 25분을 확보했다는 뜻도 아닙니다.
런북 첫 줄은 'Redis를 비우지 마라'입니다. 여기서 Redis는 캐시가 아니라 열차 상태 저장소입니다.
갱신 루프 CPU 프로파일링, 틱 CPU 792ms → 351ms
갱신 틱이 CPU를 어디에 쓰는지 몰랐습니다. 운영 dev를 건드리지 않으려고 사본 컨테이너를 띄우고 Redis DB와 Mongo 쓰기를 격리했습니다. 사본의 틱 비용이 운영과 맞는지 먼저 확인한 뒤 프로파일을 받았습니다.틱 CPU 792 → 351ms
갱신 틱이 CPU를 어디에 쓰는지 몰랐습니다. 운영 dev를 건드리지 않으려고 사본 컨테이너를 띄우고 Redis DB와 Mongo 쓰기를 격리했습니다. 사본의 틱 비용이 운영과 맞는지 먼저 확인한 뒤 프로파일을 받았습니다.
접근
self time 174초 중 시간표 직렬화가 2,238ms, 운행일 계산이 1,579ms, 정적 timedata 재파싱이 731ms였습니다. 각각 더티 추적과 5분 안전 청소, 운행일 캐시와 문자열 메모, 배열 참조 WeakMap 캐시로 고쳤습니다. ETag 해시 743ms는 v1 응답이 Express와 바이트가 같아야 해서 그대로 뒀습니다.
결과
아침 러시 기준 틱 CPU 합계가 792ms에서 351ms로 줄었습니다.
처음에는 dev와 live를 연달아 재서 'brotli가 2.8배 느리다'는 결론을 냈는데 틱이 겹친 쪽만 부풀려진 것이었습니다. 교차 실행과 중위값으로 다시 재니 인코딩과 무관하게 18~43% 차이였고 단일 원인은 찾지 못했습니다. 틀린 판정도 런북에 남겼습니다.
10분마다 256.8KB 시간표를 통째로 받던 앱, 하루 한 번 20.6KB로
v1 앱은 10분마다 하루치 시간표를 통째로 다시 받았습니다(1호선 gzip 256.8KB). 시간표 응답이 정차 시각을 절대 unix 초로 실어 내용이 같아도 날마다 전 바이트가 바뀌었습니다. 세대 번호도 프로세스 안 정수 하나라 한 노선만 다시 읽어도 모든 클라이언트가 다시 받았습니다.1호선 계획 256.8KB/10분 → 20.6KB/일
v1 앱은 10분마다 하루치 시간표를 통째로 다시 받았습니다(1호선 gzip 256.8KB). 시간표 응답이 정차 시각을 절대 unix 초로 실어 내용이 같아도 날마다 전 바이트가 바뀌었습니다. 세대 번호도 프로세스 안 정수 하나라 한 노선만 다시 읽어도 모든 클라이언트가 다시 받았습니다.
접근
GTFS static/RT 분업을 따라 계획(GetTimetables)과 실적(GetSnapshot·Subscribe)을 분리했습니다. 계획 버전은 (노선, 운행일) 내용 해시로 바꿔 blue-green 두 슬롯이 같은 값을 내고 응답은 FULL 또는 NO_CHANGE 둘뿐입니다. 정차 시각은 자정 기준 초, 역은 노선별 사전 인덱스, 열차마다 packed 열로 실었습니다.
결과
1호선 계획 전송이 10분마다 256.8KB에서 하루 1회 20.6KB로 줄었습니다(앱 실측, 개발 서버, gzip, 2026.09.04).
인코딩 효과는 노선마다 다릅니다. 정차 패턴이 고른 인천2호선 하선 236편은 40.9KB에서 2.0KB로 줄었지만 편마다 패턴이 다른 KTX는 같은 인코딩에서 60% 감소에 그쳤습니다. 이 둘은 표본이 달라 하나의 수치로 합치지 않습니다.
직선 250m 판정이 놓치던 역 통과, 선로거리 구간 판정으로 시각까지 보간
코레일 GIS 위치로 일반열차의 역 통과 시각을 내는데 처음엔 연속 두 GPS 점을 잇는 직선과 역 좌표 거리가 250m 이내면 통과로 봤습니다. 56,202개 fix·186편·30분을 재생하니 KTX 61~83%, ITX 73%였습니다. 놓친 85건 중 73건은 경로가 역 2km 안으로 오지 않았습니다. GIS 위치가 정체하다 수십 km를 점프해(이동 선분의 8.3%가 550km/h 초과) 직선 현이 곡선 선로 위 역을 멀리 지나쳤기 때문입니다.
코레일 GIS 위치로 일반열차의 역 통과 시각을 내는데 처음엔 연속 두 GPS 점을 잇는 직선과 역 좌표 거리가 250m 이내면 통과로 봤습니다. 56,202개 fix·186편·30분을 재생하니 KTX 61~83%, ITX 73%였습니다. 놓친 85건 중 73건은 경로가 역 2km 안으로 오지 않았습니다. GIS 위치가 정체하다 수십 km를 점프해(이동 선분의 8.3%가 550km/h 초과) 직선 현이 곡선 선로 위 역을 멀리 지나쳤기 때문입니다.
접근
전국 OSM(railway=rail, 34,062 ways)으로 역 436/438개를 선로에 스냅(p50 2.1m)하고 역쌍 930/940개의 폴리라인을 만들어 통과를 '연속 두 fix의 선로거리 구간이 역의 선로거리를 포함하는가'로 바꿨습니다. 점프도 1차원 구간이라 그 안의 역은 모두 통과이고 시각은 비례 보간합니다.
빌더 규칙 셋은 실측에서 나왔습니다. 복선 반대편 스냅(실패 311→10), 동명이역 해소(양원 서울/봉화), 고속선 가중치(대전|오송이 재래선으로 잡힘)입니다.
결과
선로거리 판정 단독은 재생에서 2차원보다 1~3역 뒤졌습니다(폴리라인·역 좌표 오차, 창 끝의 미확정 점프). 그래서 버리지 않고 둘의 합집합으로 확정했습니다(KTX 136≥134, ITX 74=74, 순서 위반 0).
'지나간 선로거리 구간 안의 역' 기준으로 다시 세면 2차원과 선로거리가 모두 KTX 94%·ITX 100%입니다. 집계 기준을 맞춰서 나온 값이고 커버리지가 올라가지는 않았습니다. 점프 구간 역의 시각을 폐기하지 않고 보간하며 계획과 실제 경로가 다른 열차(KTX 68: 계획 경부선, 실제 울산 고속선)를 드러내는 데서 실제 이득을 봤습니다. 후자는 시간표 품질 신호로 쓰기로 했습니다.
RAPTOR 초안이 낸 '도착보다 먼저 출발' 여정, 라운드 격리로 수정
환승 경로 탐색 초안이 '용산 06:35 도착 → 06:28 출발 열차 탑승'처럼 시간을 거스르는 여정을 에러 없이 냈습니다. 같은 라운드 안에서 방금 갱신한 도착시각을 다시 승차 판정에 썼기 때문입니다. 그럴듯한 숫자가 진짜 1회 환승 96분 답을 가렸습니다.탐색 p99 1.3ms
환승 경로 탐색 초안이 '용산 06:35 도착 → 06:28 출발 열차 탑승'처럼 시간을 거스르는 여정을 에러 없이 냈습니다. 같은 라운드 안에서 방금 갱신한 도착시각을 다시 승차 판정에 썼기 때문입니다. 그럴듯한 숫자가 진짜 1회 환승 96분 답을 가렸습니다.
접근
라운드 격리를 prev·cur·best 배열 셋으로 강제하고 승차 판정은 prev만 읽게 했습니다. 노드를 역으로 두어 같은 역에서 다시 타면 라운드가 늘고 같은 노선 급행↔완행 갈아타기도 환승으로 셉니다. 결과는 (환승수, 도착시각) Pareto 집합만 남기고 지배당한 여정은 버립니다. 이 배열 구조는 2026.09.12에 도착 route별 라벨 버킷으로 바꿨습니다(경로 탐색 절).
결과
정답 데이터가 없어서 여정이 자기 자신과 모순되지 않는지를 검사합니다. 15역쌍 × 6시각 질의에서 나온 여정 149건에서 정상 모드 위반 0건, 일부러 규칙을 깬 --broken 모드 위반 7건이었습니다. broken 모드가 실패해야 검사가 살아 있다는 뜻이라 함께 돌립니다.
탐색 지연은 평일 27노선·운행분 9,661개·정차 242,865개 위에서 p50 0.6ms·p99 1.3ms였습니다(2026.08.21 실측, 워밍업 200회 뒤 240 표본). 여정을 따라가는 WatchJourney 스트림으로 앱에 출시했습니다.
배포 중 상태 유실을 막기 위한 전환 절차
라이브는 2026.08.22까지 PM2 프로세스 하나였습니다. 배포마다 앱 연결이 끊기고 편성 투표가 중간에 잘렸습니다. 열차·편성 상태가 프로세스 메모리에만 있어 재시작하면 전 노선 지연이 0부터 다시 쌓였습니다.
라이브는 2026.08.22까지 PM2 프로세스 하나였습니다. 배포마다 앱 연결이 끊기고 편성 투표가 중간에 잘렸습니다. 열차·편성 상태가 프로세스 메모리에만 있어 재시작하면 전 노선 지연이 0부터 다시 쌓였습니다.
접근
먼저 Train/Vote Store 변경분을 틱마다 Redis에 쓰고 부팅 때 복원하게 했습니다. 그 위에 lb(nginx)·redis·api-blue·api-green 스택을 올리고 switch.sh가 active-slot·writer-slot 마커 두 줄을 한 번에 바꿉니다.
두 슬롯이 동시에 살아 있는 구간은 Redis lease로 writer를 하나만 둡니다. 편성 제보는 lease 홀더의 flush로만 Redis에 가므로 겹치는 구간에 standby로 들어온 표가 사라질 수 있어 lb에서 writer 슬롯으로 고정 라우팅합니다. replica·오토스케일은 메모리가 정본인 구조와 맞지 않아 넣지 않았습니다(ADR-0001).
결과
2026.08.30 00:38에 코레일 선로거리 판정(0.0.30)을 blue 슬롯으로 전환했습니다. lb·redis는 건드리지 않았고 blue 부팅에서 복원 trains 62·obs 6,764·relinkFailed 0, 12분 뒤 route_tracked 438·ERROR 0을 확인했습니다.
이후 릴리스도 같은 절차로 올리고 있지만 전환마다 사용자 영향을 측정하지는 않았습니다. 편성 투표 하나만 전환 순간에 상태가 어긋날 수 있는 지점으로 남아 있습니다.
지연이 바뀐 열차가 DELTA 응답에서 빠지던 문제
앱 로그에서 지연이 갱신되지 않는 열차가 보였습니다. 원인은 둘이었습니다. 스토어가 열차 객체를 제자리에서 갱신해 직전 틱과 참조 비교가 항상 같았습니다. 변경 감지 함수 protoFieldsEqual은 감시 필드를 손으로 나열해 지연 필드가 빠져 있었습니다.
앱 로그에서 지연이 갱신되지 않는 열차가 보였습니다. 원인은 둘이었습니다. 스토어가 열차 객체를 제자리에서 갱신해 직전 틱과 참조 비교가 항상 같았습니다. 변경 감지 함수 protoFieldsEqual은 감시 필드를 손으로 나열해 지연 필드가 빠져 있었습니다.
접근
원본 객체 대신 직전 틱의 proto(TripUpdate)끼리 비교하고 필드 목록을 TRIP_FIELD 표 하나로 두었습니다. 바뀐 것만 보내고 사라진 필드는 번호로 통보합니다.
결과
patchTrip 규칙을 단위 테스트로 고정했고 TRIP_FIELD 표의 번호가 proto와 어긋나면 대조 테스트가 실패합니다. proto에 필드를 늘리면서 표를 고치지 않는 경우가 이 테스트에 걸립니다.
손으로 나열하는 방식 자체는 지웠지만 모든 누락 경로를 없앴다고 보지는 않습니다. 같은 점검에서 호출되지 않는 캐시 무효화 함수도 찾아 지웠습니다.
테스트 0개인 서버를 옮기면서 응답을 바이트까지 고정했다
Express를 Fastify로 바꾼 건 성능 때문입니다. 서버는 15초마다 전 노선을 갱신하면서 요청도 받는 Node 단일 프로세스라 요청 처리 비용을 줄이고 싶었습니다. 스토어 앱은 리팩터링 중에도 v1 REST를 그대로 호출합니다. 자동 테스트가 0개인 서버를 옮기면서 응답이 달라지면 앱이 어떻게 반응하는지 확인할 방법이 없었습니다. 그래서 전환 정책을 바이트 동일로 잡았습니다. 앱이 어느 바이트까지 요구하는지는 검증하지 않고 보수적으로 고정했습니다.
그 과정에서 JSON 파싱 오류 응답이 V8 엔진 문구를 그대로 싣고 있어 Node 버전만 바뀌어도 계약이 깨지는 문제가 드러났습니다.
Express를 Fastify로 바꾼 건 성능 때문입니다. 서버는 15초마다 전 노선을 갱신하면서 요청도 받는 Node 단일 프로세스라 요청 처리 비용을 줄이고 싶었습니다. 스토어 앱은 리팩터링 중에도 v1 REST를 그대로 호출합니다. 자동 테스트가 0개인 서버를 옮기면서 응답이 달라지면 앱이 어떻게 반응하는지 확인할 방법이 없었습니다. 그래서 전환 정책을 바이트 동일로 잡았습니다. 앱이 어느 바이트까지 요구하는지는 검증하지 않고 보수적으로 고정했습니다.
그 과정에서 JSON 파싱 오류 응답이 V8 엔진 문구를 그대로 싣고 있어 Node 버전만 바뀌어도 계약이 깨지는 문제가 드러났습니다.
접근
노선·소스별 특수 규칙 115개(SP 22·LP 29·DM 64, 8개 파일 전수 조사)를 목록으로 만들고 기존 응답과 헤더를 특성화 테스트로 고정한 뒤 옮겼습니다. 두 서버를 같은 요청으로 두드려 비교하는 패리티 도구 3종(parity·header-parity·live-parity)을 CI에 넣었습니다.
v1은 엔진 문구를 어댑터에서 접어 유지하고 v2는 엔진 문구를 싣지 않는 봉투 형식으로 바꿨습니다(ADR-0003). 새 기능은 v2 표면에만 둡니다.
결과
테스트가 0개였던 서버에 2026.09.18 기준 *.test.* 파일 166개(test/contract 18 · test/unit 148)와 ADR 8편이 남았습니다. 계약 테스트는 Express 패리티, HTTP 헤더·본문 스냅샷, gRPC v1/v2 계약을 봅니다.
앱은 v2 호출이 실패하면 v1으로 폴백하도록 클라이언트 동료가 구현했습니다. 이 폴백 덕분에 서버 쪽 v2 배포가 앱보다 먼저 나갈 수 있었습니다.
2호선 열번 변경과 편성 추적
2호선 순환선은 지연이 발생하면 열번이 바뀌어 같은 열차를 계속 추적할 수 없었습니다. 단일 공공 API(SMSS)가 불안정한 문제도 함께 있었습니다. SMSS에 장애가 나면 서비스 전체가 멈췄습니다.
2호선 순환선은 지연이 발생하면 열번이 바뀌어 같은 열차를 계속 추적할 수 없었습니다. 단일 공공 API(SMSS)가 불안정한 문제도 함께 있었습니다. SMSS에 장애가 나면 서비스 전체가 멈췄습니다.
접근
서울시 열린데이터를 주 소스로 두고 SMSS는 행선지 보완과 장애 시 폴백으로 돌렸습니다. 두 응답을 같은 형식으로 바꿔 나머지 코드가 출처를 모르게 했고 노선별 예외는 Strategy에 뒀습니다.
2호선은 앞자리가 1·5가 아닌 열번에 2를 붙이는 규칙을 trainNoRewrite 지점에 걸고 SMSS 보완 병합은 그 뒤에 합니다. 순서가 바뀌면 보정 전 열번으로 병합돼 같은 열차가 둘로 갈립니다.
결과
지연 상황에서도 편성 추적이 이어지고 주 소스 호출이 실패하면 같은 요청을 대체 소스로 다시 시도합니다. 보완 실패는 로그만 남기고 서울 데이터 단독으로 계속 갑니다. 폴백이 도는지는 단위 테스트로 확인했고 실제 장애 빈도는 따로 집계하지 않았습니다.
심야에 남은 열차 상태 정리
sum(trainacc_active_trains)를 30분 간격으로 보면 01:49~04:19 KST에 38편이 고정됐습니다. 그 시각에 운행하는 열차는 없으니 19개 노선에 1~2편씩 남은 것은 전부 유령이었습니다. callAPI가 실패하면 lineUpdate가 그냥 반환돼 제거 패스가 돌지 않았기 때문입니다. 라이브도 같았습니다.
sum(trainacc_active_trains)를 30분 간격으로 보면 01:49~04:19 KST에 38편이 고정됐습니다. 그 시각에 운행하는 열차는 없으니 19개 노선에 1~2편씩 남은 것은 전부 유령이었습니다. callAPI가 실패하면 lineUpdate가 그냥 반환돼 제거 패스가 돌지 않았기 때문입니다. 라이브도 같았습니다.
접근
실패를 한 덩어리로 보지 않고 사유로 갈랐습니다. SeoulAPI INFO-200이나 SMSS의 빈 ttcVOList처럼 EMPTY일 때만, 그리고 02:00~05:00 KST일 때만 정리합니다. 타임아웃·5xx·네트워크 실패는 장애라 손대지 않습니다.
전량 삭제도 아니어서 decideToRemoveTrain이 마지막 역 도착 예정시각을 1시간 넘긴 열차만 지웁니다. 심야 응답 바디가 바뀌는 변경이라 EMPTY_CLEANUP_ENABLED로 배포 없이 되돌릴 수 있게 했습니다.
결과
제거 조건을 사유와 시각 두 개로 좁혀 장애로 데이터가 비는 상황과 실제로 운행이 끝난 상황을 구분했습니다. 낮에 순간적인 INFO-200이 와도 크게 지연된 실제 열차는 지워지지 않습니다.
38편이라는 수치는 2026.08.21 관측값이고 수정 뒤의 심야 잔존 편수는 같은 방식으로 다시 세지 않았습니다.
gRPC 응답 압축 적용 (grpc-js 미지원 우회)
서버에 압축 옵션을 걸어도 응답 크기가 그대로였습니다. @grpc/grpc-js 소스에 'response compression is currently not supported'가 적혀 있고 프레임의 compressed 비트를 항상 0으로 씁니다.시간표 응답 374→60KB
서버에 압축 옵션을 걸어도 응답 크기가 그대로였습니다. @grpc/grpc-js 소스에 'response compression is currently not supported'가 적혀 있고 프레임의 compressed 비트를 항상 0으로 씁니다.
접근
표준 grpc-accept-encoding 대신 커스텀 헤더 x-rn-accept-encoding: gzip으로 옵트인을 받아 직렬화 뒤 직접 gzip을 씌웠습니다. 작은 응답은 건너뛰고 압축 스위치는 별도 배포로 분리했습니다.
클라이언트 쪽 압축 해제(Dart codecRegistry, Swift enabledAlgorithms)는 클라이언트 동료가 켰습니다. 헤더를 보내지 않는 구버전 앱은 압축 없는 응답을 그대로 받습니다.
결과
시간표 응답이 gzip level 1로 374KB에서 60KB가 됐고 압축에 1.2ms가 들었습니다. 계약 테스트가 헤더 없는 요청과 소형 응답 건너뛰기를 고정합니다.
라이브러리 동작에 기댄 우회라 grpc-js가 응답 압축을 지원하면 걷어낼 자리입니다.
미사용 gRPC 서비스 제거
v1에 LineService·LineServiceV2·ScheduleService gRPC가 남아 있었습니다. 판정·캐시·계약 테스트를 두 벌 유지해야 하는 사본이었지만 앱이 쓰는지 확신이 없었습니다.
v1에 LineService·LineServiceV2·ScheduleService gRPC가 남아 있었습니다. 판정·캐시·계약 테스트를 두 벌 유지해야 하는 사본이었지만 앱이 쓰는지 확신이 없었습니다.
접근
오리진 nginx 접속 로그 14일(2026.08.21~09.04)을 셌습니다. 세 서비스 호출은 14건이고 전부 2026.09.04 6분 창 안의 내부 점검이었습니다. 같은 기간 편성 제보 HenseiService는 27,343건이었습니다. 출하된 앱의 gRPC 채널이 편성 제보 하나뿐인 것도 확인했습니다.
결과
2026.09.04에 세 서비스를 뺐고 proto 파일은 메시지만 남겼습니다. v2 gRPC 연동은 그 뒤 앱에 들어가 지금 스토어 버전이 쓰고 있습니다.
TrainAccAPI 리팩터링 (JS·Express → TS·Fastify)
리팩터링 전: apicall.js와 trainService.js
외부 API 호출부터 응답 변환·폴백·데이터 병합·노선별 예외까지 apicall.js 하나에 모여 있었습니다. trainService.js는 15초 폴링, 열차 생성과 종료, 시간표 찾기, 지연 계산, MongoDB 이력 저장까지 담당했습니다.
기능은 동작했지만 외부 API 하나를 고치려고 해도 지연 계산과 노선 특수 규칙까지 함께 확인해야 했습니다. 열차·편성 상태 일부가 프로세스 메모리에 있어 서버를 재시작하면 사라지는 문제도 있었습니다.
리팩터링 후: Provider·Policy·Registry·Strategy·Store

Provider는 외부 API를 호출하고 Mapper는 서로 다른 응답을 공통 형식으로 바꿉니다. Realtime Policy는 어느 소스를 먼저 쓰고 실패하면 어떻게 합칠지 정합니다. Registry에는 노선 설정을, Strategy에는 2호선·신분당선처럼 노선마다 다른 규칙을 뒀습니다.
Redis 저장과 부팅 복원은 Persistence가 맡고 app.ts는 이 객체들을 만들어 연결하는 조립 코드로 남겼습니다. 외부 API 변경은 Provider·Mapper에서, 노선별 규칙은 Registry·Strategy에서 찾습니다.
테스트가 덮는 곳과 덮지 않는 곳
2026.09.18 기준 test/ 아래 *.test.* 파일은 166개입니다. test/contract 18개는 Express 패리티, HTTP 헤더·본문 스냅샷, gRPC v1/v2 계약을 확인하고 test/unit 148개가 나머지입니다.
덮지 않는 곳도 있습니다. trainService의 도시철도 틱 경로는 41개 파일이 간접으로만 지나가고 2호선 열번 보정 규칙은 전용 단위 테스트 없이 계약 스냅샷이 결과로만 잡습니다. 신분당선 규칙은 line-sb 단위 테스트가 있습니다.
trainService.ts는 아직 큰 파일입니다. 계약 테스트가 그 경로를 충분히 덮을 때까지는 변경이 생기는 지점만 떼어냅니다.
TypeScript 타입 검사의 범위
빌드에 타입 검사를 넣어 코드 안에서 필드 이름과 형태가 어긋나는 실수를 실행 전에 잡습니다. 다만 타입은 컴파일 뒤 사라지므로 외부 API가 실제로 어떤 JSON을 주는지는 검사하지 않습니다.
외부 응답 검증은 별도입니다. 코레일 GIS는 응답이 GeoJSON FeatureCollection인지 런타임에 확인하고 아니면 예외를 던집니다. 다른 소스는 Mapper가 필요한 필드만 읽고 없으면 그 열차를 건너뜁니다.
v1 REST → v2 gRPC
v1의 문제: 시간표를 10분마다 통째로
v1 앱은 10분마다 하루치 시간표를 통째로 다시 받았습니다(1호선 gzip 256.8KB). 실시간 응답도 열차마다 행선지·정차역처럼 시간표에 이미 있는 값을 매 틱 다시 실었습니다.
시간표 gRPC(GetSched)는 정차 시각을 절대 unix 초로 내서 내용이 같아도 날마다 전 바이트가 바뀌었습니다. 시간표 세대 번호도 프로세스 안의 정수 하나여서 한 노선을 다시 읽으면 모든 노선 클라이언트가 다시 받았습니다.
v2 설계: 계획과 실적 분리, 내용 해시 버전

REST와 SSE를 그대로 두는 안도 있었지만 gRPC 전용으로 정했습니다. 첫 v2 설계는 실제로 REST와 SSE였습니다.
같은 실시간 필드를 JSON과 protobuf로 인코딩하면 2호선 974운행분이 압축 전 142,432B에서 56,479B로, gzip 후 19,594B에서 5,915B로 줄었습니다(2026.08.28). 데이터 대부분이 시각과 역 번호 같은 작은 정수라서 JSON이 숫자를 글자로 쓰고 키를 반복하는 비용이 그대로 드러났습니다. SSE의 snapshot·delta 스트림은 gRPC 서버 스트리밍으로 모양 그대로 옮길 수 있었습니다. 그리고 2025년에 만든 편성 제보가 이미 gRPC여서 앱에는 gRPC 클라이언트와 gzip 코덱이, 서버에는 gRPC 서버가 떠 있었습니다.
반대로 기존 LineService proto로 재면 1호선이 JSON 164,058B, protobuf 178,493B로 오히려 컸습니다. 열차마다 시간표 전체를 다시 싣고 있었기 때문입니다. 크기를 줄인 건 데이터 모양을 바꾼 쪽이고 protobuf는 그 위에 이득을 더했습니다. curl로 응답을 바로 읽을 수 없는 대가가 있어 상태를 바꾸는 요청은 REST로 남겼습니다. 계획과 실적을 나누는 안은 제가 내고 동료를 설득해 진행했습니다. 앱이 시간표를 받는 경로를 바꿔야 해서 논의가 필요했습니다.
GTFS static과 GTFS-RT의 분업을 따라 계획(TimetableServiceV2.GetTimetables)과 실적(RealtimeServiceV2.GetSnapshot·Subscribe)을 나눴습니다. 계획의 버전은 정수 대신 (노선, 운행일) 내용 해시로 바꿔 blue-green 두 슬롯이 같은 값을 냅니다. 응답은 FULL 또는 NO_CHANGE 둘뿐이라 델타 계산이 없습니다.
정차 시각은 자정 기준 초, 역은 노선별 사전의 인덱스, 열차마다 packed 열로 실었습니다. 정차 패턴이 고른 인천2호선 하선 236편은 gzip 40.9KB에서 2.0KB로 줄었고 편마다 패턴이 다른 KTX는 같은 인코딩에서 60% 감소에 그쳤습니다.
측정한 것과 아직 재지 않은 것
같은 6노선 시간표를 개발 서버에서 재면(2026.09.04) REST JSON 무압축 4.37MB·759ms, gzip 575KB·316ms, gRPC 383KB·58ms였습니다. 압축하지 않은 gRPC가 gzip REST보다 1.5배 작고 5.4배 빨랐습니다. 이 수치는 6노선 시간표 한 번 전송이라는 조건 안의 값입니다.
실시간 SSE에는 Accept-Encoding 협상 뒤 프레임마다 flush하는 압축을 넣어 노선 1개 snapshot 142.6KB가 gzip 19.5KB, Brotli 11.4KB로 줄었습니다.
라이브 부하 테스트 (k6, 2026.09.05)
2026.09.05 새벽 라이브 서버에 앱과 같은 경로(api.railnetwork.kr, Cloudflare 경유)로 k6 부하를 넣었습니다. 부하 생성은 대상 호스트 밖 관측 서버에서 했고 p95가 1초를 넘거나 실패율이 5%를 넘으면 자동 중단하는 가드를 걸었습니다.
같은 부하를 준 비교는 모의 클라이언트 시나리오 하나뿐입니다. v1 계획(/sched)은 개발 컨테이너(CPU 가중치 512·메모리 1GB, 라이브와 호스트 공유)에서 약 10 req/s에 p95 2.04초로 가드가 발동하고 그 직후 컨테이너가 종료됐습니다. 그래서 라이브에서는 v1을 2→8 req/s 저램프로만 재고 v2는 5→40 req/s로 쟀습니다.
표의 계획 채널 p95(v1 196ms, v2 FULL 511ms)는 요청률이 달라 직접 비교하면 안 됩니다. 모의 클라이언트 시나리오는 계획 1회 + 10초마다 실적이고 60초에 걸쳐 점진 투입한 뒤 60초 동안 유지했습니다. 전 시나리오에서 실패 0건, 라이브 health 응답은 최대 53ms였습니다.
| 시나리오 | 요청 수 | p50 | p95 | p99 | 전송량 | 서버 이벤트루프 p99 최대 |
|---|---|---|---|---|---|---|
| v1 계획 GET /sched/{line} · 2→8 req/s | 510 | 148ms | 196ms | 351ms | 79.2MB | 67ms |
| v2 계획 GetTimetables FULL · 5→40 req/s | 1,686 | 43ms | 511ms | 811ms | 220.6MB | 23ms |
| v1 실적 GET /line/multiline · 2→8 req/s | 510 | 21ms | 25ms | 30ms | 4.5MB | 34ms |
| v2 실적 GetSnapshot · 5→40 req/s | 1,724 | 15ms | 19.5ms | 28.5ms | 7.2MB | 17ms |
| v1 모의 클라이언트 (계획 1회 + 10초 폴링) | 1,043 | 24ms | 143ms | 204ms | 26.0MB | 51.5ms |
| v2 모의 클라이언트 (계획 1회 + 10초 스냅샷) | 1,044 | 16.5ms | 42ms | 65ms | 18.3MB | 21.2ms |
일반열차 추적 (코레일 GIS + OSM 선로)
수집: 전국 1회 호출과 응답 검증
코레일 GIS는 bbox 하나로 전국 열차를 한 번에 줍니다(약 85KB, 147~153편). 노선별 폴링을 만들지 않고 5초마다 전국 1회 호출하는 별도 스케줄러 틱으로 돌리고 있습니다.
인증 토큰은 없지만 Referer 헤더가 없으면 403과 HTML 오류 페이지가 옵니다. 그래서 응답이 GeoJSON FeatureCollection인지 확인하고 아니면 예외를 던집니다. HTML을 JSON인 척 흘려보내면 상위 계층에서 '열차 0편'으로 조용히 둔갑하기 때문입니다.
추적 모드 3종과 공통 Train 타입
노선마다 확보할 수 있는 데이터가 다릅니다. 도시철도 20개 노선은 REALTIME(서울 열린데이터·SMSS), 코레일은 POSITION_REPORT(GIS 위치 + 시간표), 실시간 정보가 없는 노선은 SIMULATED(시간표만)로 갱신 루프를 나눴습니다.
세 모드 모두 같은 Train 형태를 만들어 Store·라우트·gRPC는 어느 모드가 만든 열차인지 알 필요가 없습니다. 추적 모듈은 네트워크·파일·환경변수 접근 없이 require할 수 있고 시계와 저장소는 인자로 주입합니다.
같은 기준으로 다시 센 커버리지
판정 방식을 바꾼 과정은 사례 카드에 있습니다. 여기서는 바꾼 뒤 다시 센 결과만 적습니다.
56,202개 fix 재생을 '지나간 선로거리 구간 안의 역' 기준으로 다시 세면 2차원 방식과 선로거리 방식이 모두 KTX 94%·ITX 100%입니다. 처음에 본 KTX 61~83%는 판정 기하 때문이 아니라 주로 집계 기준이 이번과 달라서 나온 값이었습니다. 놓침의 대부분은 GIS 위치가 그 구간에 닿지 않은 경우였고 남은 6%는 전부 계획(시간표)이 틀린 열차의 역이었습니다.
선로거리 방식은 실제로는 점프 구간에 들어간 역의 통과 시각을 폐기하지 않고 비례 보간합니다. 계획과 실제 경로가 다른 열차(KTX 68: 계획은 경부선, 실제는 울산 고속선)도 즉시 드러냅니다. 후자는 시간표 품질 신호로 쓰기로 했습니다.
역쌍 930/940만 만들어져 결손 10쌍(동해선 삼척해변·추암, GTX 구성|동탄, 경의선 능곡|대곡)은 아직 선로거리 판정을 쓰지 못합니다.
지연 계산과 upstream_lost
코레일 지연은 업스트림이 주는 값과 시간표 대비 서버 계산값 중 큰 쪽을 씁니다. 업스트림 API는 언제든 부정확해질 수 있다는 전제로, 업스트림에서 사라진 열차를 '완주'로 기록하지 않는 규칙(upstream_lost)을 정했습니다. 종착 칸에 관측이 있으면 completed, 없으면 upstream_lost입니다.
v1 응답은 원칙적으로 동결이지만 잘못된 '완주' 기록만은 예외로 두고 정확성을 택했습니다(ADR-0007). 2026.09.10 기준 분류와 결손 디바운스까지 구현이 끝났습니다.
경로 탐색 (RAPTOR)
구현 구조와 측정, 모델링하지 않은 범위입니다. 라운드 격리를 고친 과정은 문제 해결 사례에 있습니다.
인덱스 구조
그날 쓰는 시간표(평일 또는 휴일)의 열차 한 편이 trip 하나입니다. trip은 정차역 id 배열과, 같은 길이의 승차·하차 시각 배열을 듭니다. 시각은 열차 추적과 같은 파서로 읽은 운행일 기준 초이고 시발역 하차와 종착역 승차 칸은 -1로 막습니다. 통과역은 넣지 않아서 탐색 코드에 통과역 분기가 없습니다.
노드는 역입니다. 노선이 달라도 같은 역은 한 노드이고 표기가 달라도 합칩니다(지하서울역 → 서울역). 이름만 같은 다른 역은 가릅니다(5호선 양평과 53km 떨어진 경의중앙 양평). 같은 역에서 다시 타면 라운드가 하나 늘어나므로 같은 노선 급행↔완행 갈아타기도 따로 규칙 없이 환승 1회가 됩니다.
route는 노선과 정차 패턴이 같은 trip 묶음입니다. 등급과 실제 정차 수가 뒤집힌 편성이 있어 등급 문자열로는 묶지 않습니다. route 안의 trip은 첫 출발 순으로 두고 역마다 그 역을 지나는 (route, 위치) 목록을 미리 만듭니다. 2026.08.21 평일 시간표에서 route 하나에 든 trip은 중앙값 1편, p90 10편, 최대 258편이었습니다.
trip에는 원본 시간표의 칸 번호도 둡니다. 통과역을 빼면 인덱스 위치와 원본 칸 위치가 갈리기 때문입니다. 2026.09.04 기준 코레일 991편 중 969편(97.8%)이 실제로 갈렸고 응답과 재탐색은 이 칸 번호로 승하차 지점을 가리킵니다.
라운드와 라벨
라운드 k는 k번째 승차입니다. 직전 라운드에 새 라벨이 생긴 역에서만 타고 이번 라운드가 만든 라벨은 다음 라운드부터 씁니다(격리 방식은 사례 카드에 있습니다). 새 라벨이 하나도 없거나 '최대 환승 + 1'번째 라운드가 끝나면 멈춥니다. 최대 환승 기본값은 3회입니다.
라벨이 있는 역마다 지나는 route의 trip을 전부 보고 가장 이른 라벨 도착 뒤에 출발할 수 있는 trip(지연 포함)을 모읍니다. route마다 가장 이른 trip 하나만 고르는 이진 탐색은 쓰지 않습니다. 지연을 더하면 같은 route에서도 뒤 열차가 앞 열차를 추월하고 최대 대기·도착 마감·최소금액 조건에서는 더 늦은 trip만 맞는 연결이 되기 때문입니다. route당 trip이 적어 전부 봐도 비용이 작습니다.
모은 trip은 첫 출발 순으로, 처음 탈 수 있는 위치부터 종착까지 훑습니다. 내릴 수 있는 역에서는 타고 있는 승객마다 지연을 더한 도착으로 라벨 후보를 만듭니다. 탈 수 있는 역에서는 직전 라운드 라벨마다 '도착 + 환승시간 + 사용자 여유 ≤ 출발'과 최대 환승 도보·대기를 확인합니다. 최소금액·도착 마감 검색이 아니면 먼저 탄 승객이 언제나 이기므로 승객이 하나라도 탄 trip은 뒤 역의 승차 후보를 만들지 않습니다.
라벨은 도착시각, 타고 온 route, 출발시각, 승차 횟수, 요금 상태, 구간 목록을 듭니다. 역마다 타고 온 route별로 버킷을 나누고 라운드와 상관없이 같은 버킷 안에서만 지배를 비교합니다. 승차 횟수와 도착이 모두 같거나 나으면 지배입니다. 최대 대기 조건은 도착이 같을 때만 지배로 봅니다. 도착 마감 검색은 늦은 출발을, 최소금액은 요금 상태를 기준에 더합니다.
버킷을 나눈 이유는 환승시간이 타고 온 노선마다 달라서입니다. 합성 시간표에서 X역에 1호선이 08:02, 2호선이 08:03에 닿고 3호선이 08:04에 떠나며 3호선까지 환승이 각각 300초·10초면 정답은 2호선→3호선입니다. 역마다 가장 이른 도착 하나만 두던 첫 판은 08:02 라벨이 08:03 라벨을 지워 결과가 비었습니다. 2026.09.12에 고치고 이 반례를 회귀 테스트로 남겼습니다.
trip 스캔이 끝나면 그 라운드 라벨의 스냅샷에서 도보 연결을 한 번만 풉니다. 걸어서 생긴 라벨은 같은 라운드에서 다시 타거나 도보를 잇지 않습니다. 마지막에는 목적지 라벨 중 (승차 횟수, 도착)에서 지배되지 않는 것만 남기고 목표에 맞춰 정렬합니다. 작업량이 상한(비교·스캔 500만 회, 라벨 25만 개)을 넘으면 부분 결과를 최적으로 내지 않고 오류(REST 422)로 답합니다.
가지치기, 캐시, 워커 스레드
2026.10.01에 탐색량을 줄이는 변경을 넣었습니다(탈 수 있는 trip만 모으기, 승객이 탄 trip의 추가 승차 생략, 받아들인 라벨에만 구간 목록 만들기, 목적지 하한 가지치기). 그날 시간표 질의 120개에서 최단시간·최소환승 결과는 모두 그대로였고 최단시간 p50은 144ms에서 33ms가 됐습니다. 2026.08.21의 p50 0.6ms는 역마다 도착 하나만 두던 스파이크 값이라 바로 비교하지 않습니다.
하한은 목적지에서 역방향 다익스트라를 한 번 돌려 구합니다. 간선은 route에서 이웃한 두 역 사이의 가장 짧은 주행시간과 도보 시간이고 환승은 0초로 봅니다. 그래서 실제보다 길 수 없고 '라벨 도착 + 하한'이 이미 찾은 최선 도착보다 늦을 때만 버립니다. 지연은 trip 전체를 같은 초만큼 미뤄 구간 시간이 그대로라 실시간 탐색에도 씁니다.
도착 마감 검색은 가장 늦은 출발을 찾느라 도착시각으로 가지치기를 못 합니다. 그래서 출발 창을 1·3·9·24시간으로 넓혀 가다 결과가 나온 첫 창에서 멈춥니다. 최소금액은 먼저 최단시간을 찾고 그 소요의 1.5배(최소 +30분) 안에서 찾습니다. 창 없이 하루치를 뒤지면 코레일이 끼는 역쌍 대부분이 작업 상한에 걸렸습니다. 2026.10.01 시간표 질의 40개에서 이 창의 p90은 1.0초였습니다.
탐색은 동기 CPU 작업이라 메인 스레드에서 돌면 열차 추적 틱·gRPC 스트림·헬스체크가 멈춥니다. 2026.10.01부터 워커 스레드에서 돌립니다. 바쁘면 거절 대신 줄을 세우며 같은 요청은 합쳐 한 번만 계산합니다. 최소금액은 다른 목표보다 10배쯤 무거워서(2026.10.01 dev 측정) 가벼운 요청을 먼저 내고 5초 넘게 기다린 최소금액은 먼저 냅니다.
같은 날 dev 부하 측정에서 워커 1개는 초당 약 5건이 한계였고 동시 50건일 때 헬스체크 p99는 47ms였습니다. 워커 2개로 동시 200건을 걸면 768MiB 컨테이너가 715MiB까지 차서 메모리 한도가 1.5GB 미만이면 워커를 1개로 둡니다.
환승시간 조회는 dev 규모로 모사한 시간표(2026.09.04)에서 탐색 한 번에 중앙값 6,275번 불렸지만 표본 150건 전체의 서로 다른 키는 1,395개였습니다. 그래서 (역, 노선쌍, 갈아타는 종류)를 수 하나로 묶은 키로 인덱스마다 메모합니다. 실시간 지연표는 1초 TTL일 때 거의 매 요청 다시 지어져 요청당 9.3ms를 더 썼습니다(2026.09.04 dev). 지금은 10초 틱의 스캔 시각을 키로 씁니다.
| 대상 | 키 | 버리는 시점 |
|---|---|---|
| 경로 인덱스 | 시간표 개정 번호 | 개정이 바뀔 때 (부팅·개정일·수동 재로드) |
| 다른 날짜 인덱스 | 운행일, 최대 8개 LRU | 개정이 바뀔 때 전부 |
| 목적지 하한 | 인덱스 × 목적지, 최대 64개 LRU | 인덱스가 바뀔 때 |
| 환승시간 메모 | 인덱스 × 환승표 세대 | 환승표를 바꿀 때 |
| 실시간 지연표 | 인덱스 × 실시간 스캔 시각 | 다음 스캔 (10초 틱) |
| 탐색 결과 | 인덱스 + 스캔 시각 + 요청 옵션 | 30초, 500개를 넘으면 오래된 것부터 |
계속승차와 재탐색 정책
2호선 성수와 6호선 응암에서는 같은 차량이 계속 달리는데 원본 시간표는 거기서 열번을 나눕니다. 인덱스가 이 경계를 새 승차로 세서 2026.09.12 공개 서버에서 뚝섬→건대입구와 새절→역촌이 환승 1회로 나왔습니다. 같은 노선 환승을 통째로 0회로 치면 지선 이동과 반대 방향 재승차까지 사라져서 그 방법은 쓰지 않았습니다.
원본의 다음 열번 필드가 가리키는 trip이 하나뿐이고, 앞 trip 종착역이 뒤 trip 시발역이고, 10분 안에 이어 출발하고, 정해 둔 이음매 순서(뚝섬→성수→건대입구 등)와 맞을 때만 인덱스에 연결을 붙입니다. 편성 번호나 운행일이 다르거나, 입고이거나, 후보가 둘 이상이면 붙이지 않습니다.
탐색은 앞 trip 종착에 닿은 승객을 같은 라운드 안에서 뒤 trip에 그대로 태우고 지연도 넘깁니다. trip을 첫 출발 순으로 훑고 뒤 trip은 앞 trip보다 늦게 출발해야 하므로 앞 trip이 항상 먼저 처리됩니다. 응답은 원본 trip과 칸 번호를 그대로 두고 뒤 구간에 계속승차 표시만 붙입니다. 이 결정은 ADR로 남겼습니다.
최단시간·최소환승·최소금액 비교는 엔진의 라벨 안에서 합니다. 결과 몇 개를 받아 밖에서 다시 정렬하면 시간·환승에서 밀린 싼 경로는 이미 Pareto 단계에서 빠진 뒤이기 때문입니다. 최대 환승 기본값은 2026.10.05에 2회에서 3회로 올렸습니다. 질의 30개 × 출발 3시각에서 p50은 27ms → 22ms로 느려지지 않았고 90건 중 10건에 더 빠른 3회 환승 여정이 붙었습니다.
재탐색은 타고 있는 구간과 계속승차 구간을 고정하고 나머지만 다시 찾습니다. 환승 예산은 실제 새 승차만 깎고 최대 총시간은 처음 요청 기준의 절대 마감으로 둡니다. 처음에는 같은 목표로 60초 이상 빨라지면 경로를 바꿨지만 사용자가 고른 후보가 기록에 없어 첫 틱에 엔진 1순위로 바뀔 수 있었습니다. 2026.09.18부터는 환승 연결이 불가능해졌거나 도착이 3분 이상 늦어졌을 때만 교체를 검토합니다.
무엇이 깨지면 실패하는가
정답 데이터가 없어서 여정이 자기 자신과 모순되지 않는지를 검사합니다. 승차가 하차보다 늦은가, 다음 승차가 직전 하차 + 환승시간보다 이른가, 출발 전에 탔는가, 라운드 k의 도착이 k−1보다 이른가, 통과역에서 탔는가를 봅니다.
라운드 격리가 깨지면 두 번째 규칙이 잡습니다. 초기 엔진(2026.08.21) 실측은 15역쌍 × 6시각 질의에서 나온 여정 149건에서 정상 모드 위반 0건, 일부러 규칙을 깬 --broken 모드 위반 7건입니다. broken 모드가 반드시 실패해야 이 검사가 살아 있다는 뜻이라 함께 돌립니다.
모델링하지 않은 것
이름이 다른 역 사이의 도보 연결은 환승 통로로 확인한 두 쌍(아산↔천안아산, 경전철의정부↔의정부)뿐이고 좌표가 가깝다는 것만으로는 넣지 않습니다. 같은 역 안 환승은 공개 환승표 값을 씁니다. 표에 없는 쌍은 기본값(서울교통공사 데이터 중앙값 92초, 반대편 승강장 180초)으로 계산하고 여정에 추정 표시를 붙입니다. 계단·엘리베이터 동선은 없습니다.
지연은 trip 전체를 같은 초만큼 미루는 값으로만 씁니다. 한 trip 안에서 역마다 지연이 달라지는 것(회복·누적)은 반영하지 않고 다른 날짜 검색에는 실시간을 쓰지 않습니다. 병결 열차는 후보로 표시만 하고 환승 없는 연결로 쓰지 않습니다. 최대 환승 상한은 3회입니다.
안내 중에 타고 있는 열차에서 원래 하차역보다 앞에 내려 갈아타는 최적화는 없습니다. 서버의 탑승 여부는 열차 위치로 추정한 값이고 열차를 놓친 뒤에는 사용자가 다시 검색합니다. 최소금액은 운임을 계산할 수 있는 후보 안에서 비교한 추정이라 전체망 최저운임을 보장하지 않습니다.
시스템 설계
아키텍처
외부 데이터는 Provider·Mapper에서 공통 형식으로 바꾸고 Realtime Policy가 소스 선택·폴백·병합을 결정합니다. 노선·운영사 설정은 Registry에, 신분당선 열번 추론 같은 예외는 Strategy에 둡니다.
현재 런타임 상태는 Train/Vote Store가 관리하고 Redis는 매 틱 저장과 부팅 복원을, MongoDB는 운행 이력을 맡습니다. 이력은 열차 객체 하나의 운행을 통째로 쌓고 통째로 읽기 때문에, 관계형 테이블로 나눌 이유를 찾지 못해 문서 한 덩어리로 저장합니다. Fastify REST v1·gRPC v2·SSE로 결과를 제공하고 있으며 v1 REST는 기존 앱 호환을 위해 바이트 단위로 동결했습니다.
두 공공 API를 같은 형식으로 정규화
SMSS와 열린데이터는 응답 구조와 필드 의미가 다릅니다. 데이터 출처를 서비스 코드 곳곳에서 확인하지 않도록 두 응답을 같은 형식(열린데이터 응답의 열차 목록 필드, ttcVOList)으로 바꿨습니다. 그래서 주 소스를 SMSS에서 열린데이터로 바꿀 때 열차 처리 코드는 그대로 둘 수 있었습니다.
제보 요청 검증과 제한
공공 API는 열차 편성(어떤 차량이 몇 량인지) 정보를 주지 않고 크롤링으로도 얻을 수 없어 사용자가 제보하고 다른 사용자가 투표로 검증하는 흐름을 만들었습니다.
제보 요청은 SHA-256 해시를 비교하고 타임스탬프·Nonce를 확인해 변조된 요청과 같은 요청의 재사용을 제한합니다. gRPC 제보 경로에는 요청 횟수 제한과 IP 지역 제한을 적용했고 오류는 Winston 구조화 로그로 남깁니다.
이관 후 운영 (한 달 단독 → 2인 팀)
앱·watchOS·위젯까지 이어받은 한 달
팀에서는 백엔드(TrainAccAPI)를 담당했고 이후 Flutter 앱(Dart 약 37k LOC, MVVM)·watchOS 앱·iOS 홈 위젯까지 포함한 서비스 전체를 이어받았습니다. 코드베이스를 읽어 구조를 파악하고 스토어 배포(GitHub Actions)와 장애 대응을 유지하는 것이 그 한 달의 목표였습니다.
약 한 달 뒤 원래 클라이언트를 개발하던 동료가 복귀해 지금은 2인 팀이고 저는 백엔드·인프라를 전담하고 있습니다. 앱·watchOS·위젯 구현은 그 동료가 맡고 있습니다.
서버 계약은 proto 파일을 먼저 레포에 올리고 주석에 필드가 왜 있는지까지 적는 방식으로 정합니다. 동료가 그걸 읽고 구현하고 애매한 건 채팅으로 정했습니다. 별도 문서는 만들지 않았습니다.
신규 노선 추가 (엑셀 배선도 + MapTool)
팀은 노선 배선도를 엑셀로 관리하고 Python 변환 도구(MapTool)로 앱 노선도 데이터를 생성합니다. 이 워크플로를 이어받아 경강선 등 신규 노선을 배선도 파일 작성과 변환 명령만으로 추가하고 있습니다.
변환기 코드는 240줄 남짓이고 실제 자산은 25개 노선의 승강장 위치·선로 연결이 들어 있는 엑셀 쪽입니다. 2인 팀이 이 도구로 25개 노선을 유지보수하고 있습니다.
레포 7개 점검 (2026.08)
레포가 7개로 늘어난 뒤에는 기억만으로 문제를 관리하기 어려웠습니다. 2026년 8월에 앱·백엔드·변환 도구·랜딩을 다시 확인하고 레포별 문제 목록을 만들었습니다.
이 점검에서 gRPC 델타 응답의 변경 열차 누락(사례 카드 참조)과 호출되지 않는 캐시 무효화 함수를 찾았습니다. 앱 로그에서 본 증상을 서버 코드로 따라가는 방식이라 이후로는 앱 로그 확인을 점검 절차에 넣었습니다.
인프라 (OCI VM · Portainer · Prometheus)
배포 파이프라인

라이브는 2026.08.22까지 PM2 프로세스였습니다. 앱 배포는 GitHub Actions인데 서버만 Jenkins인 건 과도기라서입니다. 서버를 OKE 플랫폼으로 옮기고 싶지만 지금 서버는 다른 리전의 프리티어 인스턴스여서 제 리전으로 옮기면 과금이 붙습니다. 지금은 Jenkins가 main·dev 푸시를 받아 typecheck·테스트·패리티를 거쳐 이미지를 만들고 Portainer 스택으로 올립니다.
라이브 스택은 lb(nginx)·redis·api-blue·api-green 넷입니다. lb의 active-slot·writer-slot 마커 두 줄을 switch.sh가 한 번에 바꿔 전환하고 두 슬롯은 Redis lease로 writer를 하나만 둡니다. standby는 잡을 걸지 않고 lease 홀더만 등록합니다.
종료 순서를 정한 이유
종료는 SIGTERM 뒤 8초 안에 진행 중 틱 대기 → 상태 큐 비움 → SSE·HTTP·gRPC 닫기 → 최종 저장 → lease 반납 순서로 끝냅니다.
순서를 정하기 전에는 최종 저장 뒤에 writer가 메모리를 다시 바꾸거나 이미 닫힌 Redis에 쓰는 구간이 있었습니다. flip 뒤 90초를 기다리는 것도 lb의 worker_shutdown_timeout이 90초라 옛 워커가 그때까지 살아 있기 때문입니다.
호스트 제약
dev와 live가 같은 2코어 호스트를 쓰고 있어 부하 실측 중 dev 컨테이너가 종료됐습니다. 용량 계획은 남은 과제입니다.
부하 생성기(k6)는 대상 호스트 밖 관측 서버(noraneko)에 두고 있습니다. 런북 첫 줄은 'Redis를 비우지 마라'입니다. 여기서 Redis는 캐시가 아니라 열차 상태 저장소여서 지우면 전 노선 지연이 0부터 다시 쌓입니다.
사용자 분석 (GA4)
GA4 속성 railnetwork-app(2026.09.05·2026.10.27·2026.10.28 조회)과 AdMob(2026.10.27 조회). 절마다 기간과 지표 정의가 다르므로 함께 적었습니다.
월간 총 사용자 추이 (2025.09~2026.10)
2026.10 총 사용자는 27일까지 7,693명으로 월 단위 최고치입니다. 1년 전 같은 달(2025.10) 3,420명의 2.2배입니다. 2025.09 3,035명부터 한 번도 줄지 않았습니다.
2025.09~2026.08 12개월 합산은 총 사용자 15,838명, 새 사용자 10,377명, 재방문 12,207명, 이벤트 4,823만 건, 사용자당 평균 참여 시간 3시간 45분이었습니다. 유입은 Organic Search 55.7%·Direct 46.7%(채널 중복 포함)이고 광고는 집행하지 않았습니다.
| 월 | 총 사용자 | 월 | 총 사용자 |
|---|---|---|---|
| 2025.09 | 3,035 | 2026.04 | 4,851 |
| 2025.10 | 3,420 | 2026.05 | 5,325 |
| 2025.11 | 3,820 | 2026.06 | 5,349 |
| 2025.12 | 4,270 | 2026.07 | 5,704 |
| 2026.01 | 4,337 | 2026.08 | 6,094 |
| 2026.02 | 4,411 | 2026.09 | 6,510 |
| 2026.03 | 4,839 | 2026.10 (1~27일) | 7,693 |
최근 28일 (2026.09.29~10.26)
총 사용자 7,797명, 새 사용자 2,591명, 재방문 6,174명입니다. 30일·7일·1일 활성 사용자는 7.8천·4.3천·1.9천 명이고 DAU/MAU 24.1%, DAU/WAU 43.5%, WAU/MAU 55.5%입니다. 직전 측정(아래 절)과 비교하면 30일 활성은 약 6천 명에서 7.8천 명으로, 1일 활성은 1.7천 명에서 1.9천 명으로 늘었고 DAU/MAU는 29.0%에서 24.1%가 됐습니다.
활성 사용자당 평균 참여 시간은 52분 50초, 참여 세션 15회, 세션당 3분 05초입니다. 이벤트 633만 건 중 열차 상세 조회(page_trainDetails)가 140만 건, 역 상세 48만 건, 노선 상세 37만 건입니다. 활성 사용자는 Android 71.6%·iOS 28.4%이고 비정상 종료 없는 사용자 비율은 Android 98.6%·iOS 98.0%입니다.
앱 광고 (AdMob)
2026.09 한 달 광고 요청은 414만 회, 노출은 145만 회, 일치율은 63.12%였습니다(AdMob 미디에이션 보고서). 1년 전 같은 달(2025.09)에는 광고 기록이 없습니다.
최근 7일(2026.10.20~26)은 요청 164만 회, 노출 48.8만 회, 일치율 55.02%입니다. 노출의 74%가 Android이고 형식은 대부분 배너입니다. 보상형 광고 노출은 같은 7일 동안 109회였습니다.
재방문·참여·유지 (2026.08.08~09.04)
이 28일 동안 활성 사용자는 5,997명이고 그중 재방문이 5,246명(87.5%), 새 사용자가 1,016명이었습니다. DAU/MAU 29.0%, DAU/WAU 45.7%, WAU/MAU 63.5%로, 30일 활성 6천 명 중 하루 평균 1.7천 명이 들어옵니다.
활성 사용자당 평균 참여 시간은 28일 동안 55분 19초, 참여 세션 17회, 세션당 2분 53초였습니다. 열차를 확인하고 바로 닫는 짧은 세션이 하루 여러 번 반복되는 패턴입니다.
신규 사용자 유지는 1일째 30.4%, 8일째 15.1%, 34일째 약 11%입니다(2026.09.04에 끝나는 42일 기준). 같은 28일의 이벤트 414만 건 중 열차 상세 조회(page_trainDetails)가 129만 건으로 가장 많았습니다.
지역 분포와 기간이 다른 집계
2025.11~2026.02 Firebase Analytics 기준으로 서울 68%·경기 22%·기타 10%였습니다. 같은 90일 동안 이벤트 1,200만 건 이상, 활성 사용자 6,375명이 기록됐습니다.
이 6,375명은 90일 창의 활성 사용자이고 위의 5,997명은 28일 창의 활성 사용자라 서로 비교하는 값이 아닙니다. metrics의 6,510명은 또 다른 정의(2026.09 한 달의 총 사용자)입니다.
작업 순서의 변화 (2024 → 2026)
같은 서버를 2024년에 두 번, 2026년에 한 번 고쳤습니다. 앞의 둘은 라이브에 못 올렸습니다. git 이력과 ADR에 남은 것만 적었습니다.
리팩터링 순서: 2024년과 2026년
2024년 3월 커밋 메시지는 'code refactoring, apply later', 4월은 'still problem arises (ONLY USE IN LOCAL)'입니다. 구조를 먼저 바꾸고 나서 동작이 같은지 확인하려 했는데 확인할 방법이 없어서 라이브에 올리지 못했습니다.
2026년 8월에는 거꾸로 했습니다. 노선·소스별 특수 규칙 115개를 목록으로 만들고 기존 응답과 헤더를 특성화 테스트로 고정한 뒤(Phase 0), 그 테스트를 돌리면서 apicall.js와 trainService.js의 책임을 Provider·Policy·Registry·Strategy·Domain으로 옮겼습니다.
이때부터 변경 전에 '이 변경이 깨지면 무엇이 알려주나'를 먼저 확인하고 있습니다.
레거시 호환: v1 응답 동결
리팩터링 중에도 스토어에 있는 앱은 v1 REST를 그대로 호출합니다. 그래서 v1은 필드 이름은 물론 헤더 순서와 오류 본문까지 바이트 단위로 동결했습니다. Express에서 Fastify로 옮기는 동안에는 두 서버를 같은 요청으로 두드려 응답을 비교하는 패리티 도구(parity·header-parity·live-parity)를 만들어 CI에 넣었습니다.
JSON 파싱 오류 응답이 V8 엔진의 문구를 그대로 싣고 있어서 Node 버전이 바뀌면 계약이 깨지는 문제도 이때 발견했습니다. v2에서는 엔진 문구를 싣지 않는 봉투 형식으로 바꿨습니다(ADR-0003). 새 기능은 전부 v2 표면에만 두고 v1은 손대지 않는 것이 규칙입니다.
계획서와 실측
절 번호가 붙은 계획서를 먼저 쓰고 구현은 그 절 단위로 합니다. 이번 리팩터링에서 계획서가 틀린 지점이 세 번 있었습니다.
gRPC 시간표 인코딩의 바이트 계산에서 trip_id 열 하나를 빼고 세어 구현 후 재측정과 3~5% 어긋났습니다. 원인을 찾아 표 옆에 '세지 않은 열이 있었다'고 적었습니다. 관광열차를 새마을호와 가르던 열번 대역 규칙은 업스트림이 둘을 같은 코드로 준다는 걸 확인하고 지웠습니다. 코레일 선로거리 판정은 계획서에서 커버리지 90%를 기대했는데 재생하니 기존 방식보다 1~3역 뒤져서 버리지 않고 둘을 합집합으로 확정했습니다.
셋 다 재생·재측정·로그가 잡았습니다. 이후로는 계획서 항목마다 '틀렸다면 무엇으로 알 수 있나'를 같이 적습니다.
남은 것
trainService.ts는 여전히 큽니다. 운영 중인 핵심 경로라 계약 테스트가 그 경로를 충분히 덮을 때만 잘라낼 생각입니다.
dev와 live가 같은 2코어 호스트를 쓰고 있어 용량 계획이 필요합니다. 선로거리 판정은 결손 역쌍 10개가 남아 있고 선로 데이터의 버킷 연동도 컨버터 파이프라인에 붙일 때까지는 scp로 둡니다.
다시 만든다면 SSE는 넣지 않을 겁니다. v2 Subscribe와 역할이 겹쳐 전송 표면이 셋이 됐고 지금은 v1 앱 호환 때문에 유지하고 있습니다.