Noraneko Platform
개인 서비스의 배포와 설정을 한곳에서 다루려고 만든 배포 플랫폼입니다. OCI OKE 위에서 앱 레포의 dev 브랜치에 병합하면 개발 서버로, release 브랜치에 병합하면 운영 서버로 나갑니다. 빌드는 OCI DevOps가, 배포는 Argo CD가 맡습니다. 지금은 oshi@log 서버와 관리 콘솔, RailNetwork-JP 개발 서버, 제 서버 보안 점검에 쓰는 LLM 에이전트 침투 테스트 도구 artex(ARTEX 한국어판)가 여기서 돌아갑니다.
- 상태
- Production
- 기간
- 2026.07 – 현재
- 역할
- 1인 개발·운영
- 기술
- OCI OKE · A1 ARM64, Terraform, Argo CD, Helm, OCI DevOps · OCIR, OCI Vault · External Secrets Operator, cert-manager · OCI Certificates, OCI Native Ingress Controller · WAF, Cilium, Cloudflare Tunnel · Access, Tailscale · Tailscale Kubernetes operator, Grafana Cloud · Alloy · Tempo, Headlamp, OCI Vulnerability Scanning, OCI Notifications
- Argo CD Application (app-of-apps)
- 21개
- 배포 방식 전환 중 측정한 요청의 응답 코드 (전부)
- HTTP 200
- 백업이 이보다 오래되면 알림
- 26시간
- Grafana 대시보드 (코드로 관리)
- 24개
- A1 ARM64 노드 (앱·데이터 / 플랫폼)
- 2대
주요 성과
- Kaname(Kargo fork)와 Argo Rollouts를 upstream Argo CD와 일반 Deployment로 바꿨습니다. 새 Deployment가 Ready가 된 뒤 90초를 기다렸다가 Rollout을 지우는 순서로 옮겨 전환 중 측정한 요청이 모두 200이었습니다
- root Application 하나가 Argo CD Application 21개를 만듭니다(app-of-apps). 앱은 oshilog-api·admin의 dev·prod, oshilog-data, artex, railnetwork-jp-api(dev)이고 나머지는 플랫폼 구성 요소입니다
- 팀 접근 권한을 미리 만들어 두었습니다. OCI IAM 그룹 ops·devs는 이 클러스터에만 권한을 받고, RBAC로 ops는 dev·prod 편집과 클러스터 조회, devs는 dev 편집과 prod 조회를 받습니다. 아직 팀원은 없습니다
- OCI 비용은 월 15~16 USD입니다. Always Free를 넘는 부분은 A1 1 OCPU·4GB와 블록 스토리지 100GB입니다
- PostgreSQL 덤프를 매일 클러스터 밖 버킷에 올리고 격리 환경 복원 훈련을 통과했습니다(dev 123테이블·prod 37테이블)
- 레포에는 지금 돌아가는 것만 남겼습니다. Kaname·Kargo Project·Argo Rollouts·옛 VM 트리와 지난 문서를 지우고 결정 기록은 유효한 24개만 남겼습니다
- RailNetwork-JP는 development 환경으로 옮겼습니다. RailNetwork는 아직 기존 VM에서 돌고 있습니다
담당 작업
- OCI 춘천에 VCN·OKE·DevOps·IAM·WAF·예산·알람을 Terraform으로 세웠습니다. 모듈 6개·41파일·2,030줄입니다. state는 OCI Object Storage 백엔드에 두고 주 1회
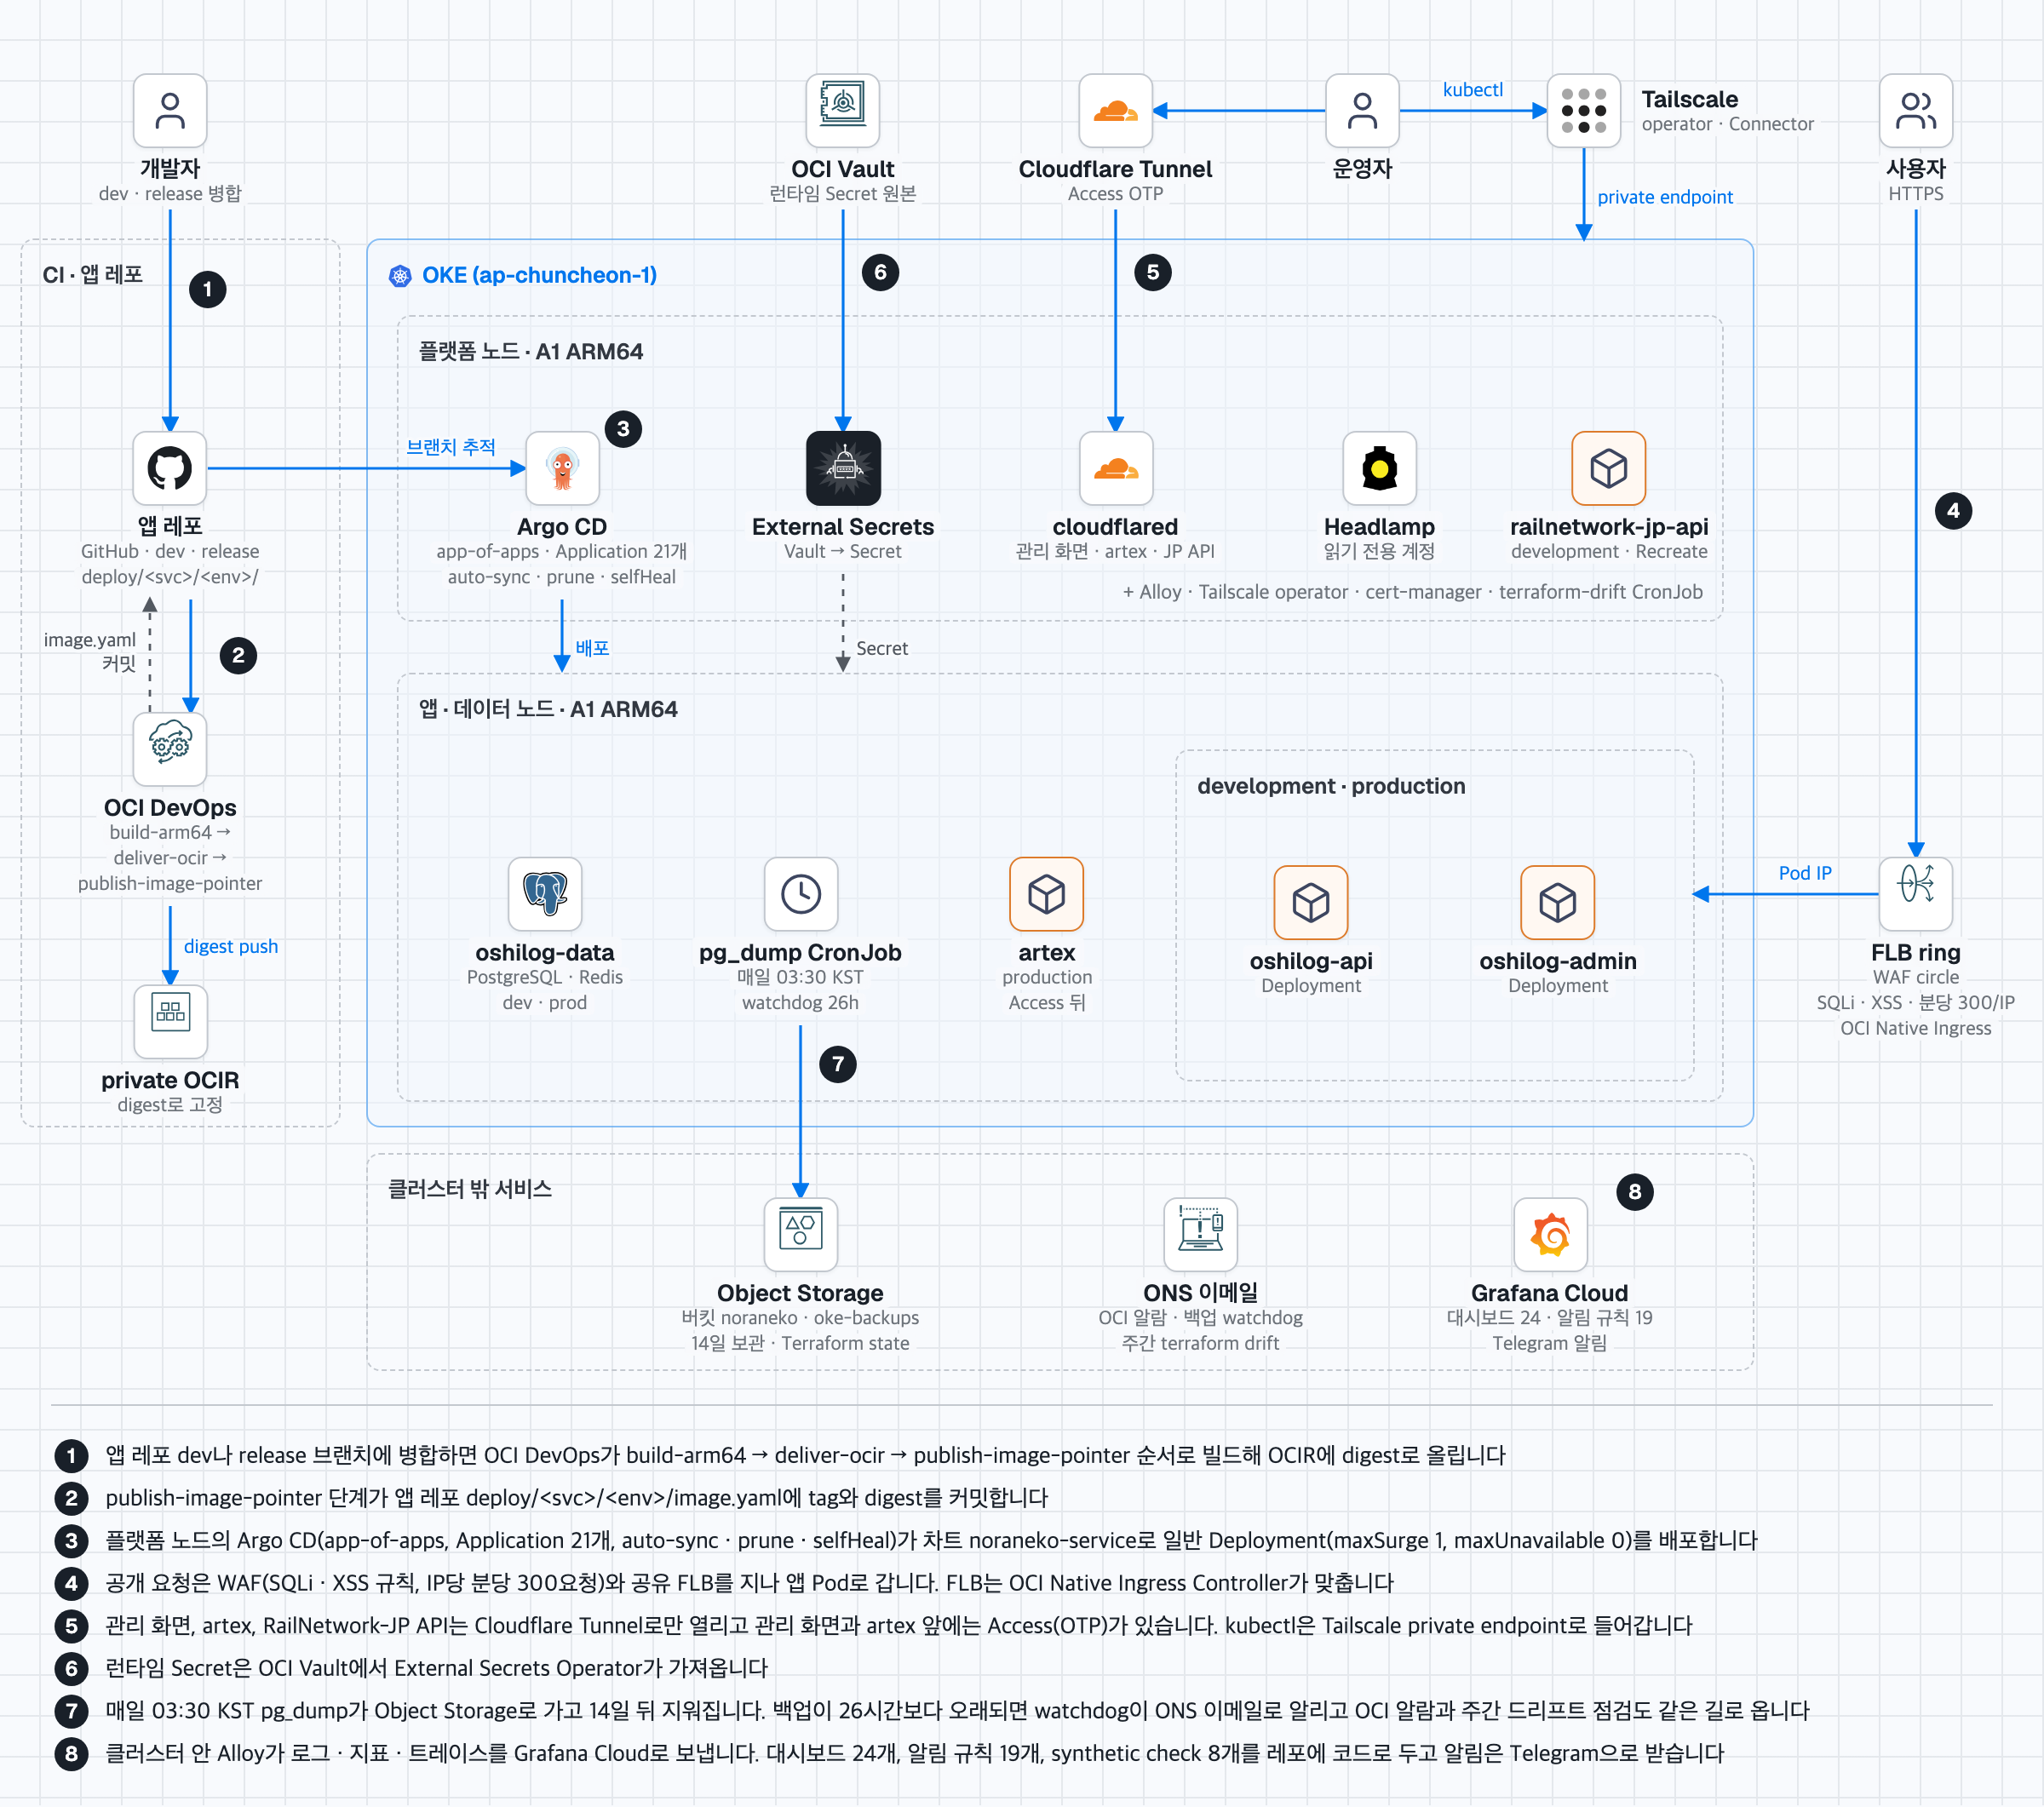
terraform plan을 돌리는 CronJob이 바뀐 자원을 ONS로 알립니다. - 앱 레포는 dev·release·main 세 브랜치를 씁니다. dev에 병합하면 개발 서버로, release에 병합하면 운영 서버로 나갑니다. Argo CD가 고정 브랜치를 따라가야 해서 버전 번호를 붙인 release 브랜치는 만들지 않습니다.
- 빌드는 OCI DevOps만 합니다. GitHub Actions는 월 사용 한도가 있어서 빌드를 OCI 쪽으로 모았습니다.
build-arm64→deliver-ocir→publish-image-pointer순서로 돌고 마지막 단계가 앱 레포deploy/<svc>/<env>/image.yaml에 tag와 digest를 커밋합니다. 그래서 버전을 올리거나 되돌리는 일은 앱 레포에서 끝나고 이 레포는 서비스를 추가하거나 플랫폼을 바꿀 때만 고칩니다. - release 빌드의 소스가 dev에서 확인한 소스와 같으면 dev 이미지를 그대로 운영 포인터에 씁니다. 이미지 태그는
<APP_VERSION>-build.<UTC YYYYMMDDHHMM>이고 같은 태그가 OCIR에 있으면 빌드를 멈춥니다. 배포는 digest로 고정합니다. - 빌드 러너가 x86이고 QEMU를 쓸 수 없어서 컴파일은 x86에서 교차로 하고 arm64 단계는 COPY만 합니다. 무거운 런타임이 필요한 artex는 런타임을 베이스 이미지로 분리했습니다.
- 공개 요청은 WAF를 붙인 공유 FLB 하나로만 들어옵니다. OCI Native Ingress Controller가 Ingress를 읽어 listener와 backend를 맞춥니다. readiness gate 때문에 FLB backend가 건강해진 뒤에야 Pod가 Ready가 됩니다. WAF에는 SQLi·XSS 관리형 규칙과 IP당 분당 300요청 제한을 걸었습니다.
- Argo CD·Headlamp 같은 관리 화면과 artex, RailNetwork-JP API는 공개 FLB를 타지 않고 Cloudflare Tunnel로만 엽니다. 관리 화면과 artex 주소 앞에는 Cloudflare Access(일회용 PIN)를 두었습니다.
- 운영자 kubectl은 private API endpoint로 들어갑니다. 클러스터 안 Tailscale operator의 Connector가 그 서브넷을 tailnet에 광고합니다. 공개 endpoint는 exit node VM 한 곳(/32)만 허용하는 비상 경로로 남겼습니다. tailnet 정책은 git 파일로 두고 스크립트로 반영하며 정책 테스트가 잘못된 변경을 막습니다.
- 관측은 Grafana Cloud 무료 티어로 보냅니다. 클러스터 안 Alloy Deployment 하나가 Pod 로그(API 서버 경유), 이벤트, kubelet·cAdvisor, kube-state-metrics, node-exporter, 앱 지표를 모으고 허용 목록으로 활성 시계열 약 10k 중 6.3k만 남깁니다. oshi@log 트레이스는 OTLP로 Alloy를 거쳐 Tempo로 갑니다.
- 대시보드 24개(직접 만든 20개는 Python 생성기로 만듭니다), 알림 규칙 19개, 도쿄에서 5분마다 도는 HTTP synthetic check 8개를 모두 레포에 코드로 둡니다. 알림은 Telegram으로 받고 항상 울리는 Watchdog 알림을 heartbeat webhook으로 보내 알림 경로가 살아 있는지도 확인합니다.
- 런타임 시크릿은 OCI Vault에 두고 External Secrets Operator가 가져옵니다. OCI DevOps는 빌드·OCIR push·포인터 커밋 권한만 있고 클러스터에는 쓸 수 없습니다.
- dev·prod PostgreSQL을 매일 03:30에
pg_dump로 클러스터 밖 Object Storage에 올리고 14일 뒤 지웁니다. 09:00에 도는 watchdog이 26시간보다 오래된 백업을 찾으면 ONS로 알립니다.
문제 해결 사례
제목을 누르면 접근과 결과가 펼쳐집니다.
Kargo를 fork까지 했다가 upstream Argo CD로 돌아온 이유
Kargo를 fork한 Kaname이 적용·승격·정리를 모두 맡았습니다. 업스트림 추격은 포기한 구성이었고 워크로드는 Argo Rollouts canary였습니다. Git을 정본으로 관리하는 구조인데 Kaname을 거친 배포 상태가 Git과 달라지는 부분이 생겼습니다.
Kargo를 fork한 Kaname이 적용·승격·정리를 모두 맡았습니다. 업스트림 추격은 포기한 구성이었고 워크로드는 Argo Rollouts canary였습니다. Git을 정본으로 관리하는 구조인데 Kaname을 거친 배포 상태가 Git과 달라지는 부분이 생겼습니다.
접근
upstream Argo CD로 다시 옮겼습니다. 공용 차트가 selector를 바꾸지 않은 일반 Deployment를 그리게 하고 버전 포인터는 앱 레포로 옮겼습니다. 새 Deployment가 Ready가 된 뒤 90초를 기다렸다가 Rollout을 지우는 순서로 바꿨습니다.
결과
전환 중 측정한 요청은 모두 200이었습니다. Kaname 빌드 파이프라인과 Kargo Project, Argo Rollouts는 걷어내고 OCIR 이미지는 남겨 두었습니다.
백업 watchdog이 첫 실행부터 오탐
PostgreSQL 백업 CronJob과 함께 넣은 watchdog이 첫 실행에서 백업이 없다고 알렸습니다.
PostgreSQL 백업 CronJob과 함께 넣은 watchdog이 첫 실행에서 백업이 없다고 알렸습니다.
접근
OCI CLI가 지원하지 않는 정렬 옵션을 빼고 객체 목록을 ISO 타임스탬프로 정렬해 최신 백업을 고르게 바꿨습니다. 26시간 비교도 ISO 타임스탬프를 python으로 파싱해서 하게 했습니다. 명령 줄 연결을 끊던 빈 줄과 ONS 발송 인자도 고쳤습니다. 백업 Pod가 PostgreSQL 5432에 닿도록 NetworkPolicy를 더했습니다.
결과
고친 뒤 격리 Job으로 복원 훈련을 해서 dev 123테이블, prod 37테이블이 복원되는 것을 확인했습니다.
관리 화면 앞에 Cloudflare Access
Argo CD와 Headlamp는 Cloudflare Tunnel로만 열었지만 화면 앞에는 계정 로그인과 공유 토큰뿐이었습니다.
Argo CD와 Headlamp는 Cloudflare Tunnel로만 열었지만 화면 앞에는 계정 로그인과 공유 토큰뿐이었습니다.
접근
deploy·k8s·artex 주소 앞에 Cloudflare Access(일회용 PIN, 운영자 이메일만 허용)를 붙였습니다. Argo CD 기본 admin 계정은 끄고 운영자 계정 하나만 남겼고 Headlamp 세션은 읽기 전용으로 바꿨습니다.
결과
세 주소는 운영자 이메일로 받은 일회용 PIN을 넣어야 열립니다. Gatus를 쓰던 동안에는 세 주소에서 302가 돌아오는지로 Access가 막고 있는지 확인했습니다.
VPN이 끊기면 kubectl이 통째로 막히던 API 접근 경로
OKE API NSG가 운영자 CIDR 하나만 허용했습니다. 노트북이 VPN에서 빠지면 kubectl이 timeout이 나고 배포도 복구도 전부 막혔습니다. 작업 중 두 번 겪었습니다.
OKE API NSG가 운영자 CIDR 하나만 허용했습니다. 노트북이 VPN에서 빠지면 kubectl이 timeout이 나고 배포도 복구도 전부 막혔습니다. 작업 중 두 번 겪었습니다.
접근
보조 CIDR 목록 변수 operator_extra_cidrs를 추가하고 각 항목을 /24 이하로 제한했습니다. 0.0.0.0/0은 변수 검증에서 막습니다. 운영자는 Tailscale exit node로 나가 허용된 주소를 씁니다.
결과
운영자 접근 경로를 exit node 하나로 모았고, 다른 경로가 필요하면 보조 CIDR 목록에 /24 이하로 더합니다. 그 뒤 Tailscale operator로 private endpoint 경로를 열어 exit node가 멈춰도 kubectl을 쓸 수 있게 됐습니다. 공개 endpoint는 exit node 한 곳(/32)만 허용하는 비상 경로로 남겼습니다.
span이 0인 Tempo를 16일 만에 걷어냄
관측 스택에 Tempo를 넣어 뒀는데 트레이스가 쌓이지 않았습니다. 확인해 보니 두 Alloy 설정 어디에도 OTLP 수신이 없어 span을 보내는 구성 요소가 처음부터 없었습니다. 호스트의 /srv/platform/tempo/data가 16일 동안 40KB였습니다.
관측 스택에 Tempo를 넣어 뒀는데 트레이스가 쌓이지 않았습니다. 확인해 보니 두 Alloy 설정 어디에도 OTLP 수신이 없어 span을 보내는 구성 요소가 처음부터 없었습니다. 호스트의 /srv/platform/tempo/data가 16일 동안 40KB였습니다.
접근
컨테이너만 내리지 않고 관련된 설정을 전부 찾아 지웠습니다. compose 서비스, OTLP 포트, monitoring/tempo/, Grafana 데이터소스와 Loki 트레이스 링크, Prometheus 스크레이프 타깃, 대시보드 span 패널, 호스트 준비 스크립트의 데이터 디렉터리, 토폴로지 테스트 기대치까지입니다.
결과
compose에 잡아 두었던 mem_limit: 400m·cpus: 0.15 예약과 항상 비어 있던 대시보드 패널이 없어졌습니다. 그 호스트는 퇴역시키기로 했고 레포에서 옛 VM 트리를 통째로 지웠습니다.
설계 결정
Kubernetes로 옮긴 이유
VM 4대에 Docker Compose와 Portainer로도 서비스는 돌아갔습니다. Kubernetes를 실제 운영에서 써 보려고 옮겼습니다. 개인 입장에서는 경험을 쌓는 목적이 컸습니다. 여기서 겪은 Argo CD·GitOps 구성은 회사 EKS 전환을 설계할 때 그대로 참고가 됐습니다. 호스트마다 흩어진 배포·설정·시크릿·관측을 한 곳에서 다루고 싶기도 했습니다.
전에는 서비스가 늘 때마다 호스트에 들어가 Compose 파일과 Ansible 변수를 따로 고쳤습니다. 지금은 앱 레포의 브랜치에 병합하면 배포가 끝납니다. 대신 노드는 ARM64 A1 두 대(각 2 OCPU·12GB), 로드밸런서는 10Mbps 한 대로 묶었습니다.
OCI Resource Manager로 옮기지 않은 이유
Terraform을 콘솔에서 돌리려고 OCI Resource Manager를 검토했습니다. list-terraform-versions로 확인하니 지원 버전이 최대 1.5.x였습니다. 코드는 1.10 이상을 요구하고 변수 간 참조 검증은 1.9부터 됩니다. 그래서 1.5.7에서는 init이 깨집니다. 그 검증을 빼면 통과는 하지만 지원 종료 버전과 로컬 1.13.5를 이중 관리하게 됩니다.
이관은 하지 않고 state를 원격으로 옮기는 것과 드리프트 알림만 적용했습니다. state는 OCI Object Storage 네이티브 백엔드로 넘겼고 이관 뒤 plan 변경은 0이었습니다. 드리프트 CronJob 첫 실행은 커밋하지 않은 파일 하나를 '삭제 예정'으로 잡았습니다. 그 파일을 커밋하고 다시 돌리니 변경 없음으로 끝났습니다.
릴리스 경로
브랜치와 환경
앱 레포는 영구 브랜치 dev·release·main을 씁니다. dev는 개발 서버로, release는 운영 서버로 가고 main은 태그를 단 release를 fast-forward로 받는 기록용입니다. feature·bugfix 브랜치는 dev에서, hotfix 브랜치는 release에서 땁니다. 이 인프라 레포만 예외로 main과 작업 브랜치를 씁니다.
빌드와 이미지 포인터
서비스마다 파이프라인이 둘입니다. dev push는 <svc>-build가, release push는 <svc>-release-build가 받습니다. 마지막 단계가 앱 레포의 image.yaml에 tag와 digest를 커밋하고 dev 빌드는 development를, release 빌드는 production을 씁니다.
release 빌드의 소스가 dev에서 확인한 소스와 같으면 새로 빌드한 이미지 대신 그 dev 이미지를 운영 포인터에 씁니다. 개발 서버에서 본 이미지와 운영 이미지가 같은 digest가 됩니다.
배포와 되돌리기
Argo CD가 서비스·환경마다 Application 하나(<svc>-<env>)를 두고 production도 auto-sync, prune, selfHeal을 켭니다. 워크로드는 일반 Deployment(maxSurge 1, maxUnavailable 0)입니다. 롤백도 앱 레포에서 끝나고 이 레포는 손대지 않습니다.
예외는 DB입니다. oshilog-data는 차트가 바뀌면 DB Pod 네 개가 재시작돼서 auto-sync를 끄고 운영자가 Argo CD 화면에서 시점을 골라 sync합니다.
접근 제어와 권한
관리 화면
관리 화면은 공개 FLB를 거치지 않습니다. cloudflared가 Tunnel로 Argo CD와 Headlamp를 엽니다. Argo CD 사람 계정은 운영자 하나이고 기본 admin은 꺼 두었습니다. Headlamp 세션은 읽기 전용이고 쓰기와 Secret 읽기는 kubectl로 합니다.
관리 화면 앞의 Cloudflare Access는 문제 해결 사례에 적었습니다.
운영자 API 접근
OKE API의 NSG는 운영자 CIDR과 보조 CIDR 목록(항목마다 /24 이하)만 허용하고 0.0.0.0/0은 변수 검증에서 막힙니다. 평소에는 Tailscale operator의 Connector가 tailnet에 광고한 private endpoint로 접속하고, 공개 endpoint는 exit node VM 한 곳(/32)만 허용하는 비상 경로로 둡니다. kubeconfig는 운영자 개인 OCI API 키로 만듭니다.
권한 경계
ClusterRole은 플랫폼 컨트롤러(Cilium, cert-manager, ESO, NIC, Argo CD)와 읽기 전용 Headlamp 계정만 가집니다. AppProject는 앱용과 도구용 두 개로 대상 namespace를 묶습니다. 사람, 자동화 사용자, 동적 그룹, ServiceAccount는 신원을 서로 재사용하지 않습니다.
팀원용으로 OCI IAM 그룹 ops·devs를 만들고 그룹을 RBAC에 묶었습니다. ops는 dev·prod 편집과 클러스터 조회, devs는 dev 편집과 prod 조회를 받고 guests는 클러스터에 접근하지 못합니다. 아직 팀원은 없습니다.
공급망과 공개 경로
이미지 고정과 취약점 스캔
앱 이미지는 digest로 배포하고 플랫폼 도구 이미지도 repo:tag@sha256:...로 적습니다. digest가 빠진 파일은 테스트 스크립트가 잡습니다. OCIR은 OCI Vulnerability Scanning이 훑습니다.
이미지 서명과 admission 정책은 두지 않았습니다. BASIC 클러스터라 OKE 이미지 검증 정책을 쓸 수 없고 Kyverno 같은 컨트롤러는 노드 두 대에 비해 무겁습니다. 스캔 결과 알림도 아직 붙이지 않았습니다.
WAF 요청 제한
WAF는 관리형 규칙 두 개(SQLi, XSS)에 더해 클라이언트 IP당 분당 300요청을 넘으면 60초 동안 429를 돌려줍니다. 베타 트래픽 기준으로 정한 값이라 실제 사용자가 걸리면 한도부터 올립니다.
데이터와 알림
백업과 복원 훈련
dev·prod PostgreSQL과 Redis는 oshilog-data namespace에서 앱 노드 위에 돕니다. 매일 03:30에 환경별 CronJob이 pg_dump를 떠서 버킷에 올리고 lifecycle 규칙이 14일 뒤 지웁니다. 09:00 watchdog은 환경별 최신 백업이 26시간보다 오래됐거나 없으면 알립니다.
복원 훈련과 watchdog 오탐을 고친 과정은 문제 해결 사례에 적었습니다.
알림과 관측
지표·로그·트레이스는 Grafana Cloud 무료 티어로 보냅니다. 클러스터 안 Alloy Deployment 하나가 Pod 로그를 DaemonSet 없이 API 서버로 읽고 이벤트, kubelet·cAdvisor, kube-state-metrics, node-exporter, 앱 지표를 모읍니다. 허용 목록 relabel로 활성 시계열 약 10k 중 6.3k만 남깁니다. OCI 지표는 읽기 전용 IAM 사용자로 OCI Metrics 플러그인이 가져옵니다.
대시보드 24개, 알림 규칙 19개(지표 17·로그 2)와 SLO 기록 규칙 1개, synthetic check 8개는 레포에 코드로 둡니다. 알림은 Telegram으로 받고 Watchdog 알림을 heartbeat webhook으로 보내 알림 경로도 확인합니다. 예산과 CPU·메모리 같은 OCI 알람, 백업 watchdog, 드리프트 CronJob은 지금도 ONS 이메일로 옵니다.
처음에는 Gatus 상태 페이지 한 화면으로 상태를 봤는데 Grafana Cloud로 옮기면서 걷어냈습니다.
남은 일
다음 작업
RailNetwork를 OKE로 옮기는 것이 다음 작업입니다. 첫 실제 dev → release 릴리스로 운영 배포 절차를 확인하는 일도 남아 있습니다. artex 베이스 이미지는 지금 손으로 빌드해 올리고 있어서 갱신이 잦아지면 arm64 네이티브 빌더를 검토합니다.